
Cloudflare a récemment fait une proposition choc : les propriétaires de sites pourront décider de faire payer les robots d’IA pour accéder aux contenus de millions de sites. Ce changement discret pourrait transformer durablement les règles du jeu sur le web pour les éditeurs, les référenceurs et les IA elles-mêmes.

L’accès gratuit au contenu web, c’est (bientôt) fini pour les IA ?
Cloudflare, l’un des piliers de l’infrastructure web mondiale, vient de lancer “Pay Per Crawl”, une initiative qui change la donne :
Les robots d’IA (comme GPTBot ou ClaudeBot) devront désormais payer pour crawler certains contenus.
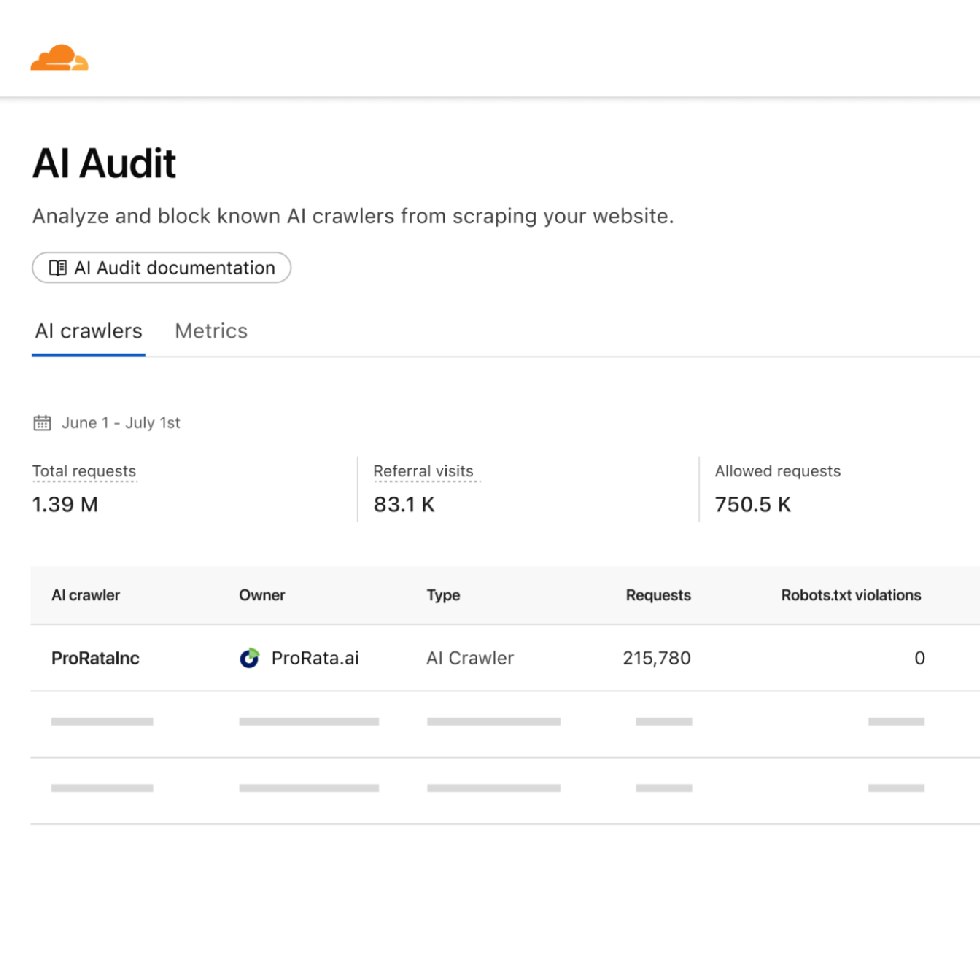
Le fonctionnement repose sur une norme technique peu utilisée : le code HTTP 402 – Payment Required.
Cela permet à chaque site de répondre à un robot avec une condition : “OK pour l’accès, mais seulement si tu paies”.
Trois options sont désormais disponibles pour les éditeurs via l’interface Cloudflare :
- Autoriser librement l’accès (HTTP 200)
- Refuser tout accès (HTTP 403)
- Demander un paiement par requête (HTTP 402 + prix affiché)
C’est une première : les données ne sont plus “gratuites par défaut” sur le web.
Et avec plus de 20 % des sites mondiaux protégés par Cloudflare, l’impact peut être massif.
Pourquoi les IA appauvrissent les sites sans qu’on s’en rende compte ?
Avant, le deal était clair : vous laissez les moteurs de recherche lire vos pages, et en retour ils vous envoient du trafic.
C’est grâce à ce trafic que vous monétisez via la pub, l’abonnement ou les ventes.
Mais ce contrat tacite est en train de s’effondrer.
Les IA ne jouent pas le même jeu. Elles lisent vos contenus mais ne vous renvoient presque jamais de visiteurs.
Voici les ratios actuels relevés par Cloudflare :
| Robot | Crawls | Visites redirigées |
|---|---|---|
| 18 | 1 | |
| OpenAI (GPTBot) | 1 500 | 1 |
| Anthropic (ClaudeBot) | 60 000 | 1 |
Les IA consomment massivement les contenus, mais sans jamais en citer les sources ni générer de clics.
Résultat ? Perte de trafic, perte de revenus, perte de contrôle.
Le contenu devient un actif numérique négociable (et monétisable)
Grâce à Pay Per Crawl, chaque éditeur peut désormais fixer ses propres conditions d’accès :
- Quel robot est autorisé (ou bloqué)
- À quel prix le contenu peut être lu par un crawler IA
- Quels usages sont acceptables : génération de texte, entraînement de modèles, recherche
Cette approche transforme le contenu web en une forme de “licence API” : l’information devient monnayable, selon les règles de celui qui la produit.
SEO, contenus, IA : ce que les pros du digital doivent anticiper dès maintenant
1. Repenser la visibilité dans les réponses d’IA
Faut-il bloquer l’accès aux IA, le faire payer ou le laisser gratuit pour rester visibles dans leurs réponses ?
La visibilité dans ChatGPT ou Claude passera-t-elle par un “choix économique” ?
2. Valoriser son contenu comme une ressource stratégique
Tout contenu web, article, fiche produit, documentation, pourrait demain devenir une source de revenus si l’IA doit le payer pour l’utiliser.
Les éditeurs peuvent enfin reprendre la main.
3. Éviter une fracture du web entre “riches” et “pauvres” contenus
On risque de voir se créer deux types de web :
- Un web premium, protégé et réservé aux IA capables de payer
- Un web libre, gratuit mais pillé
Un tel clivage pourrait pénaliser les plus petits éditeurs ou les startups sans notoriété. Le débat sur l’ouverture ou la protection des contenus ne fait que commencer.
Mon point de vue : enfin un levier pour rééquilibrer la valeur
Cloudflare ne propose pas juste un blocage.
Il offre un levier stratégique aux éditeurs : celui de faire payer ce qui a de la valeur. Et en 2025, la donnée en a plus que jamais.
Cela ne veut pas dire que tout contenu doit devenir payant pour l’IA, mais que ce choix revient enfin à ceux qui produisent l’information.