L’essentiel en bref
- Muse Spark 1.3 (xhigh) score 61 sur l’Artificial Analysis Intelligence Index, à égalité avec GPT-5.6 Sol (max) et Claude Opus 5 (high), pour un tarif inchangé de 1,25 $ et 4,25 $ par million de tokens.
- Son coût mesuré par tâche est de 0,55 $ contre 0,95 $ pour GPT-5.6 Sol, soit un écart de 42 % là où le prix du token de sortie affiche un rapport de 1 à 4,7.
- La variante max, celle du tableau de benchmarks diffusé par Meta, reste en preview limitée pour ses partenaires et sans tarif public.
Accès rapide (Sommaire) :
Ce que Meta a réellement mis en ligne le 2 septembre
Muse Spark 1.3 est accessible depuis le 2 septembre 2026 via le Meta Model API et dans Muse Code, l’agent de codage en terminal de l’entreprise. C’est la quatrième version de la famille Muse Spark en cinq mois, après un lancement initial en avril.
Le modèle arrive en deux variantes de raisonnement. La version xhigh est celle que vous pouvez appeler aujourd’hui, la version max reste en preview limitée pour les partenaires de Meta, dans l’attente de tests de sécurité complémentaires.
Sur l’Intelligence Index d’Artificial Analysis, xhigh score 61, à égalité avec GPT-5.6 Sol en mode max, Grok 4.6 en mode high et Claude Opus 5 en mode high. La variante max monte à 62, derrière les seuls Claude Fable 5.1 (66) et Claude Opus 5 (63).
Le tarif ne bouge pas depuis Muse Spark 1.1 : 1,25 $ par million de tokens en entrée, 4,25 $ en sortie, sur une fenêtre de contexte d’un million de tokens. Mark Zuckerberg a résumé l’annonce sur X en parlant de performances frontière « almost too cheap to meter ».
Si vous faites tourner des agents en production, c’est la première fois qu’un modèle à ce niveau d’intelligence descend sous les 5 $ le million de tokens en sortie (mais attention à ne pas vous précipiter sans vérifier les petites lignes, car elles méritent qu’on s’y attarde).
Pourquoi quatre fois moins cher par token ne fait pas quatre fois moins cher par tâche ?
Le rapport de prix affiché par Meta est spectaculaire. Face aux 4 $ et 20 $ de GPT-5.6 Sol, tarif promotionnel garanti au moins jusqu’au 21 novembre 2026, et aux 5 $ et 25 $ de Claude Opus 5, Muse Spark 1.3 divise par 4,7 le prix du token de sortie.
Le coût réellement mesuré par des benchmarks indépendant en revanche ne dit pas la même chose. Artificial Analysis calcule 0,55 $ par tâche de son index pour Muse Spark 1.3 (xhigh), contre 0,95 $ pour GPT-5.6 Sol (max), 0,94 $ pour Grok 4.6 (high) et 1,23 $ pour Claude Opus 5 (high).
L’écart passe donc de 470 % sur le tarif à 42 % sur la facture, et l’explication tient en un mot : la verbosité. Pour boucler l’Intelligence Index, Muse Spark 1.3 a produit 100 millions de tokens, contre une médiane de 71 millions sur les modèles comparables.
En clair : un budget construit sur la grille tarifaire de Meta sous-estimera votre dépense réelle. La seule mesure qui tranche entre deux fournisseurs, c’est le coût moyen par tâche terminée sur vos propres traces d’exécution, pas le prix au million de tokens. Notre comparatif du coût réel des principaux LLM détaille la méthode de calcul.
Le tableau de benchmarks de Meta compare un modèle que vous ne pouvez pas acheter avec ceux que vous utilisez déjà
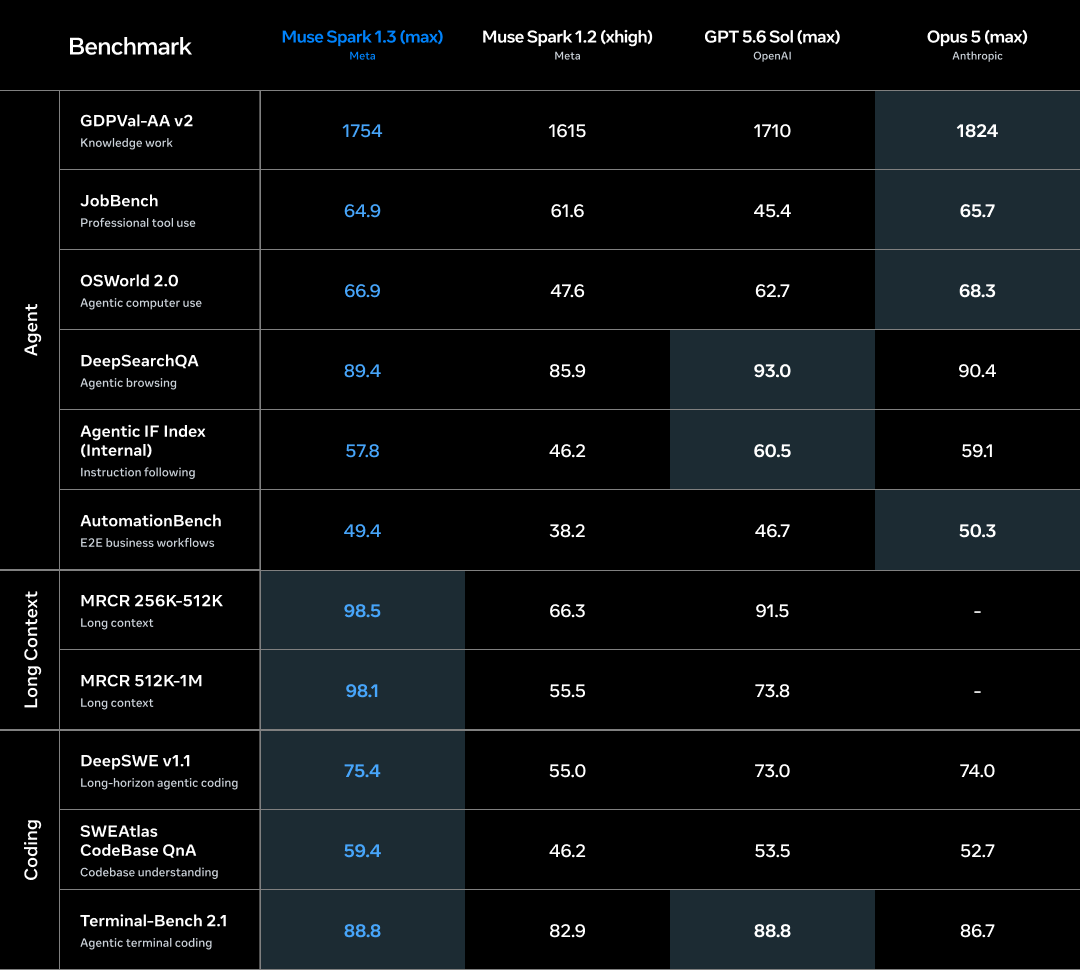
Le comparatif diffusé par Meta oppose Muse Spark 1.3 (max) à GPT-5.6 Sol (max) et Claude Opus 5 (max). Or max est justement la variante en preview limitée, sans tarif public, ce qui a conduit Artificial Analysis à l’exclure de ses comparaisons de coût.
Le détail qui compte ? Même sur ce tableau, Claude Opus 5 passe devant sur quatre des six benchmarks agentiques : GDPval-AA v2 (1824 contre 1754), JobBench (65,7 contre 64,9), OSWorld 2.0 (68,3 contre 66,9) et AutomationBench (50,3 contre 49,4).
GPT-5.6 Sol l’emporte de son côté sur DeepSearchQA (93,0 contre 89,4) et sur l’index interne de suivi d’instructions (60,5 contre 57,8).
Muse Spark garde deux avantages intéressant à garder en tête : sur le contexte long, il écrase la concurrence avec 98,5 et 98,1 sur MRCR entre 256K et 1M de tokens, là où GPT-5.6 Sol tombe à 73,8 sur la tranche haute ; côté codage, il prend DeepSWE v1.1 (75,4) et SWEAtlas CodeBase QnA (59,4).
Si votre cas d’usage principal consiste à faire raisonner un agent sur un dépôt entier ou sur des centaines de pages de documentation, ces deux lignes sont vraiment importantes pour vous et peuvent peser dans la balance. Pour de l’automatisation métier de bout en bout, elles ne seront toutefois pas suffisantes.
Face à Muse Spark 1.2, l’efficience recule
Meta gagne quatre points d’intelligence sur sa propre version d’août, de 57 à 61. Le coût par tâche, lui, monte de 0,40 $ à 0,55 $, soit 37 % de plus.
La cause est claire : Artificial Analysis relève environ 57 % de tokens d’entrée supplémentaires par tâche sur ses runs. Évaluer la 1.3 lui a coûté 810 $, contre 639 $ pour la 1.2.
Deux évaluations reculent au passage. AA-LCR tombe de 83 % à 79 %, et l’exactitude sur AA-Omniscience perd trois points pour la variante xhigh, sur un taux d’abstention plus élevé.
En clair : le progrès est réel sur les tâches agentiques (mais payé via plus de tokens dépensés).
Ce que ça change dans vos arbitrages de modèle ?
Sur le plan de l’efficience, aucun modèle scorant 59 ou plus ne coûte moins par tâche que Muse Spark 1.3. Les plus proches sont Gemini 3.8 Flash (59, 0,58 $) et GLM-5.3 (60, 0,68 $), tous deux en dessous en intelligence.
Reste que le choix ne se joue plus sur la grille tarifaire, mais sur le volume de tokens que votre workload consomme vraiment et sur la variante que vous avez le droit d’appeler. Pour situer les autres options du marché, notre panorama des modèles d’IA les plus performants est mis à jour à chaque sortie.
Un point important à ne pas négliger pour finir : le tarif de GPT-5.6 Sol à 4 $ et 20 $ est promotionnel et court au moins jusqu’au 21 novembre 2026, sans qu’OpenAI ait annoncé ce qui suit (il faut donc bien prendre cela en compte dans vos calculs de rentabilité car les prix vont vraisemblablement rapidement augmenter, et l’introduction en bourse qui approche pourrait accélérer les choses…).
Notre verdict :
Muse Spark 1.3 est le bon choix par défaut pour des agents à fort volume, à condition de mesurer son coût sur vos propres exécutions et non sur la grille tarifaire de Meta. Le modèle est verbeux, et c’est la verbosité qui fixe la facture, pas le prix du token.
Fondateur de LEPTIDIGITAL et SUPASST, je suis également consultant spécialisé en acquisition de leads B2B (SaaS). Passionné par le marketing digital, l’intelligence artificielle et le SEO. Avant de devenir indépendant, j’ai occupé des postes clés en tant que SEO Manager et responsable e-commerce pour plusieurs grandes entreprises (Altice Media, Infopro Digital, Voyage Privé et le Groupe ERAM). Sur le plan perso, je suis un curieux insatiable, également passionné par la photographie, le badminton et les voyages. Pour toute demande de partenariat, privilégiez LinkedIn ou email ([email protected]).