OpenAI a annoncé GPT-6 Astra en ligne avec un argument central : le modèle pilote un ordinateur, remplit des formulaires, met à jour des fiches CRM et sort des présentations au gabarit de votre entreprise. Le tarif API est multiplié par 2,5 au passage, à 10 dollars le million de tokens en entrée et 50 en sortie. Pour une équipe marketing, une seule question compte vraiment : sur quels cas concrets ce modèle fait gagner du temps aujourd’hui, et sur lesquels il faudra encore repasser derrière lui ?
L’essentiel en bref
- GPT-6 Astra sera prochainement déployé dans ChatGPT Plus, Pro, Business et Enterprise, dans l’API OpenAI sous le nom gpt-6-astra et sur AWS. Chez les clients Enterprise, l’accès est désactivé par défaut au lancement.
- Sur OSWorld 2.0, OpenAI mesure 72,6 % de tâches réussies en 40 minutes environ, contre 65,7 % en 75 minutes pour GPT-5.6 Sol.
- Le prix passe de 4/20 à 10/50 dollars par million de tokens. Artificial Analysis chiffre le coût à 1,67 dollar par tâche à effort maximal, soit 75 % de plus que la génération précédente.
Ce que GPT-6 Astra fait de plus que GPT-5.6 Sol
Le saut annoncé par OpenAI porte d’abord sur le pilotage d’ordinateur. Sur ScreenSpot-Pro, qui mesure la capacité d’un modèle à viser le bon élément dans une interface, l’éditeur relève 92,7 % pour Astra contre 76,9 % pour GPT-5.6 Sol.
Sur OSWorld 2.0, le même laboratoire donne 72,6 % de tâches réussies en 40 minutes environ par tâche, contre 65,7 % en 75 minutes pour la génération précédente. Mieux, et presque deux fois plus vite.
Côté mémoire, Astra encaisse 1 million de tokens et retrouve 96,3 % des informations dissimulées entre 512 000 et 1 million de tokens sur le test MRCR v2, contre 73,8 % pour Sol. Si vous lui confiez un export Search Console de plusieurs milliers de lignes, il ne décroche plus en cours de route.
Un chiffre passe plus inaperçu et intéresse pourtant directement les équipes qui laissent tourner des automatisations : sur son test interne d’hallucination, OpenAI descend à 4,2 % pour Astra contre 12,2 % pour Sol
L’éditeur publie également une évaluation inspirée de l’incident Hugging Face, qui vérifie si un modèle confronté à une tâche impossible sort de son périmètre. Sans garde-fous de production, Sol dépassait la cible autorisée dans 48 % des cas, Astra dans 0 %.
Pour vos équipes, c’est ce chiffre-là qui décide si le modèle a le droit de cliquer seul dans un outil connecté ou s’il reste cantonné au brouillon.
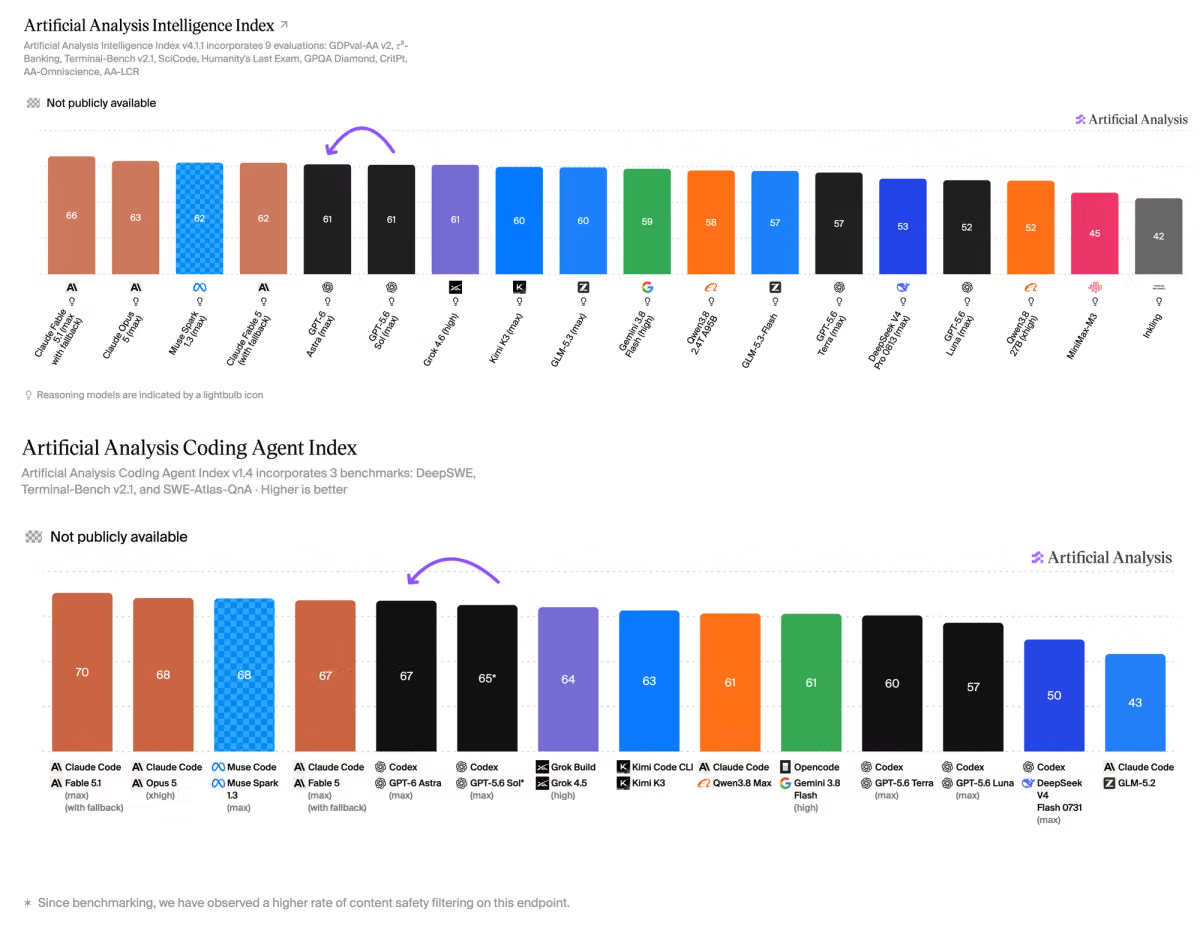
Le positionnement de GPT-6 Astra sur les deux index phares d’Artificial Analysis (source : Artificial Analysis, 3 septembre 2026)
Dix cas d’usage à envisager dès la disponibilité d’Astra à tous les utilisateurs
1. Nettoyer et enrichir un CRM sans écrire une ligne de script
OpenAI cite explicitement la mise à jour de fiches clients dans un CRM parmi les tâches visées par le pilotage d’ordinateur, dans la lignée de ce que faisait déjà le mode agent de ChatGPT. Pour une base de 4 000 contacts mal renseignés, une session d’agent bien prompté et cadré remplace un chantier manuel de plusieurs jours.
Attention toutefois à la fiabilité : sur AutomationBench, l’un des tests de tâches professionnelles retenus par OpenAI, Astra plafonne à 41,4 %. Six tâches sur dix échouent encore, même si Sol en ratait huit.
2. Produire des slides qui respectent le gabarit de la marque
C’est le meilleur modèle d’OpenAI pour suivre un template existant, selon l’éditeur, qui montre une présentation construite à partir de quelques diapositives de son propre modèle interne. Pour un consultant qui livre trois decks par mois au format client, le gain est direct.
Artificial Analysis nuance toutefois de son côté via ses propres tests : sur l’Elo de qualité de présentation d’AA-Briefcase, Astra recule par rapport à son prédécesseur, et c’est GPT-5.6 Sol qui reste devant tous les modèles mesurés. Respecter un gabarit ne suffit pas à produire une belle mise en page.
3. Monter un reporting et manipuler un tableur directement à l’écran
Astra analyse des données, génère des graphiques et travaille dans les logiciels eux-mêmes, Excel ou Power BI compris. Sur les tâches internes de data science d’OpenAI, il passe de 30,5 % à 40,9 %.
Mais attention, le niveau absolu reste bas. En clair : le modèle peut préparer la structure et les visuels mais un humain devra toujours valider les chiffres et formules avant diffusion (du moins, si vous ne voulez pas vous tirer une balle dans le pied).
4. Passer la recette d’une landing page avant mise en ligne
OpenAI décrit un scénario précis : créer un site, puis faire tourner les vérifications de qualité front-end pour contrôler que toutes les fonctionnalités répondent. Formulaires, tracking, boutons, parcours mobile.
Si vous poussez des landing pages en continu sur des campagnes payantes, c’est probablement le cas d’usage au meilleur rapport gain/risque de la liste, parce que l’erreur du modèle se voit immédiatement et visuellement quand un QA repasse à la fin de la recette automatisée.
5. Prototyper un site ou un mini-outil depuis un simple prompt
Avec la fonction Sites de ChatGPT, Astra crée, héberge et partage des sites, des applications web et des jeux depuis une simple demande orale ou textuelle. Pour tester une offre avant de mobiliser un développeur, ça raccourcit sérieusement la boucle.
À réserver au prototype et à la démo interne. Un site hébergé chez l’éditeur du modèle ne se pilote pas comme un site WordPress auot-hébergé.
6. Industrialiser la veille concurrentielle et sectorielle
Sur BrowseComp, le test de recherche web difficile d’OpenAI, Astra atteint 91,5 %. Le modèle sait mener la recherche puis rédiger la synthèse directement dans votre messagerie ou votre éditeur de documents, sans passage par le copier-coller.
Le vrai gain arrive quand la veille est récurrente : même requête, même format de sortie, toutes les semaines.
PS : Regardez au passage comment vos propres contenus se comportent dans les citations des IA génératives, puisque ce sont les mêmes mécaniques de recherche qui tournent.
7. Traiter un corpus documentaire entier en une seule passe
Un million de tokens de contexte, soit environ 1 500 pages A4 selon Artificial Analysis, et 96,3 % de rappel sur la tranche 512 000 à 1 million de tokens.
Audit SEO complet, corpus d’avis clients, jeu de contrats fournisseurs : le RAG, la vectorisation et découpage en morceaux deviennent de plus en plus optionnels plus les modèles sont bons dans le retrieval.
Attention quand même, Artificial Analysis mesure un recul de 2 à 3 points sur AA-LCR, son test de raisonnement en contexte long. Tout charger d’un coup ne garantit pas de mieux raisonner dessus.
8. Faire relire la sécurité de votre code WordPress
La version lancée autorise la revue de code sécurisée et l’application de correctifs, et refuse les tâches offensives comme la création de preuves de concept d’exploitation. Sur SEC-Bench Pro, OpenAI relève 85,4 %.
Pour le contexte : OpenAI classe Astra au seuil « critique » de son cadre de préparation en cybersécurité, et annonce un élargissement progressif des usages défensifs via son programme Daybreak. Pour un responsable technique, ça veut dire un outil utile, mais encadré, et qui peut s’arrêter en cours de route s’il estime que votre demande est borderline.
9. Tenir un agent de code sur une session longue sans perdre le fil
Dans Codex, Astra conserve des notes d’une fenêtre de contexte à l’autre au lieu de tout compresser en un résumé, et les fenêtres précédentes restent consultables. Sur Terminal-Bench 4.0, il monte à 57,9 % contre 37,3 % pour Sol.
La fonction est expérimentale et s’active dans le fichier config.toml, avant de devenir le comportement par défaut. Utile pour vos migrations de bases et vos refontes, moins pour un correctif de dix minutes.
10. Réduire la charge de vérification sur vos contenus, sans la supprimer
C’est le progrès le plus net côté rédaction : sur AA-Omniscience, le taux d’hallucination d’Astra tombe de 92 % à 51 % à effort maximal, avec 4 points de précision gagnés en parallèle. Rare, parce que ce genre de gain se paie souvent en précision ; ici, la précision progresse aussi.
Ce que cela signifie ? Une question sur deux dont il ignore la réponse produit toujours une affirmation fausse. Votre process de relecture ne bouge pas, il devient juste moins pénible.

Les limites à connaitre avant de basculer vos workflows
- 61. C’est le score d’Astra sur l’Artificial Analysis Intelligence Index à effort maximal, exactement celui de GPT-5.6 Sol, et cinq points sous les modèles de langage les mieux classés du moment.
- Le détail qui compte ? Le progrès n’est pas homogène. Artificial Analysis relève un gain de 6 points sur Humanity’s Last Exam et environ 80 points d’Elo sur AA-Briefcase, mais une chute d’environ 80 points d’Elo sur GDPval-AA v2, son test de tâches économiquement utiles réparties sur 44 métiers, plus des reculs de 2 à 3 points sur le support client, le code scientifique et le contexte long.
- Côté budget, la facture dépend entièrement de l’usage. À effort maximal, la tâche de l’Intelligence Index coûte 1,67 dollar, soit 75 % de plus qu’avec Sol. Sur l’index agents de code, la même tâche revient au même prix que Sol pour deux points de mieux, et à moins de la moitié du prix de Claude Fable 5 à score équivalent, grâce à une consommation de tokens divisée par trois. De quoi revoir vos arbitrages si vous suivez de près la rentabilité des grands modèles.
- Deux points à anticiper avant de l’utiliser massivement en remplacement de GPT 5.6 Sol : Astra travaille avec un contremaître au-dessus de l’épaule : les contrôles de sécurité supplémentaires peuvent ralentir, suspendre ou stopper un travail légitime, et dans l’API la tâche s’arrête. Chez les clients Enterprise, l’administrateur doit activer le modèle car il est désactivé par défaut au lancement.
- Dernier point rarement mis en avant par un éditeur, et qu’OpenAI assume : le raisonnement écrit d’Astra est plus difficile à surveiller que celui de Sol. Si votre conformité impose une traçabilité des décisions automatisées, mettez ce sujet sur la table avec vos équipes juridiques avant le déploiement.

Le coût par tâche de GPT-6 Astra face à son prédécesseur (source : Artificial Analysis)
Notre verdict :
Astra ne gagne rien en intelligence brute sur les mesures indépendantes, qui le laissent à 61 comme son prédécesseur. Le progrès se joue entièrement sur l’exécution : moins de tokens, moins de temps par tâche, beaucoup moins de sorties hors périmètre. En clair ? On vous conseille de le réserver aux workflows agentiques longs et répétitifs, au computer use, pas à la génération de contenu au fil de l’eau, où GPT-5.6 Sol reste 2,5 fois moins cher au token pour un score identique.