Claude Fable 5.1 et GPT-6 Astra ont été mesurés à deux jours d’intervalle par Artificial Analysis, le 1er et le 3 septembre 2026. Même tarif affiché, même fenêtre de contexte d’un million de tokens, et pourtant deux profils qui n’ont presque rien en commun une fois les résultats aux benchmarks comparés côte à côte. Lequel…
L’essentiel en bref
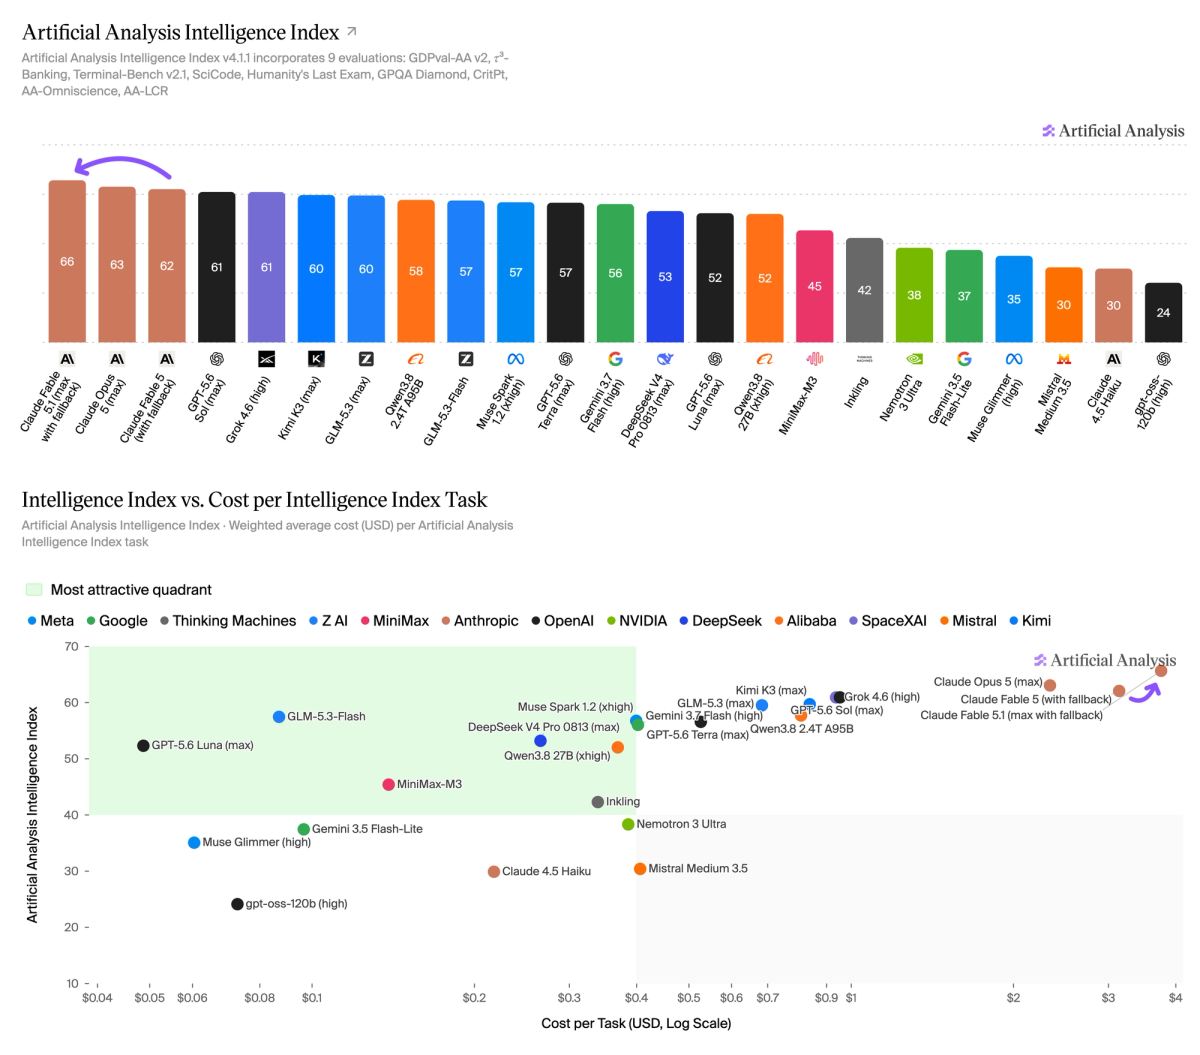
- Claude Fable 5.1 domine l’Artificial Analysis Intelligence Index avec 66 points à effort maximal. GPT-6 Astra en obtient 61, soit le score de son prédécesseur GPT-5.6 Sol.
- Le tarif de base est identique, à 10 et 50 dollars le million de tokens. La tâche revient pourtant à 1,67 dollar avec Astra contre 3,76 dollars avec Fable 5.1, à cause de la consommation de tokens.
- Anthropic a divisé par quatre le prix de la lecture de cache, à 0,25 dollar le million de tokens, quand OpenAI reste à 1 dollar. Sur un agent qui relit le même contexte en boucle, l’écart pèse lourd.
Prix, contexte et disponibilité : ce qu’il faut retenir de ce comparatif au sommet
10 dollars le million de tokens en entrée, 50 en sortie. Les deux modèles affichent rigoureusement le même tarif standard, et la même fenêtre de contexte d’un million de tokens.
La première différence se joue sur le cache : Anthropic a fait tomber la lecture de cache de 1 à 0,25 dollar le million de tokens, une baisse de 75 % qui, selon Artificial Analysis, économise environ 1,40 dollar par tâche, concentrée sur les évaluations agentiques où la majorité des tokens d’entrée sont des relectures de cache. OpenAI applique de son côté une remise de 90 % sur ses 10 dollars, soit 1 dollar le million.
Attention toutefois :
- chez les clients ChatGPT Enterprise, Astra est désactivé par défaut au lancement et doit être activé par un administrateur.
- Anthropic, pour sa part, route par défaut les requêtes signalées par ses filtres vers Claude Opus 4.8 ou Claude Opus 5, un mécanisme dont Artificial Analysis précise qu’il a servi environ 4 % des tokens produits pendant ses tests. Les équipes qui ont vécu l’indisponibilité temporaire de Claude Fable 5 cet été savent déjà à quel point ce genre de détail se paie en production.
Intelligence générale : Fable 5.1 devant, Astra au niveau de GPT-5.6 Sol
Artificial Analysis place Claude Fable 5.1 en tête de son Intelligence Index avec 66 points à effort maximal, le meilleur score jamais mesuré par la plateforme, devant Claude Opus 5 à 63 et GPT-5.6 Sol à 61. GPT-6 Astra arrive précisément à 61, sans progression sur son prédécesseur, et se retrouve au coude à coude avec plusieurs concurrents de notre classement des grands modèles de langage.
La moyenne masque toutefois des évolutions contradictoires et c’est dans les détails des benchmarks qu’il faut creuser pour faire le bon choix :
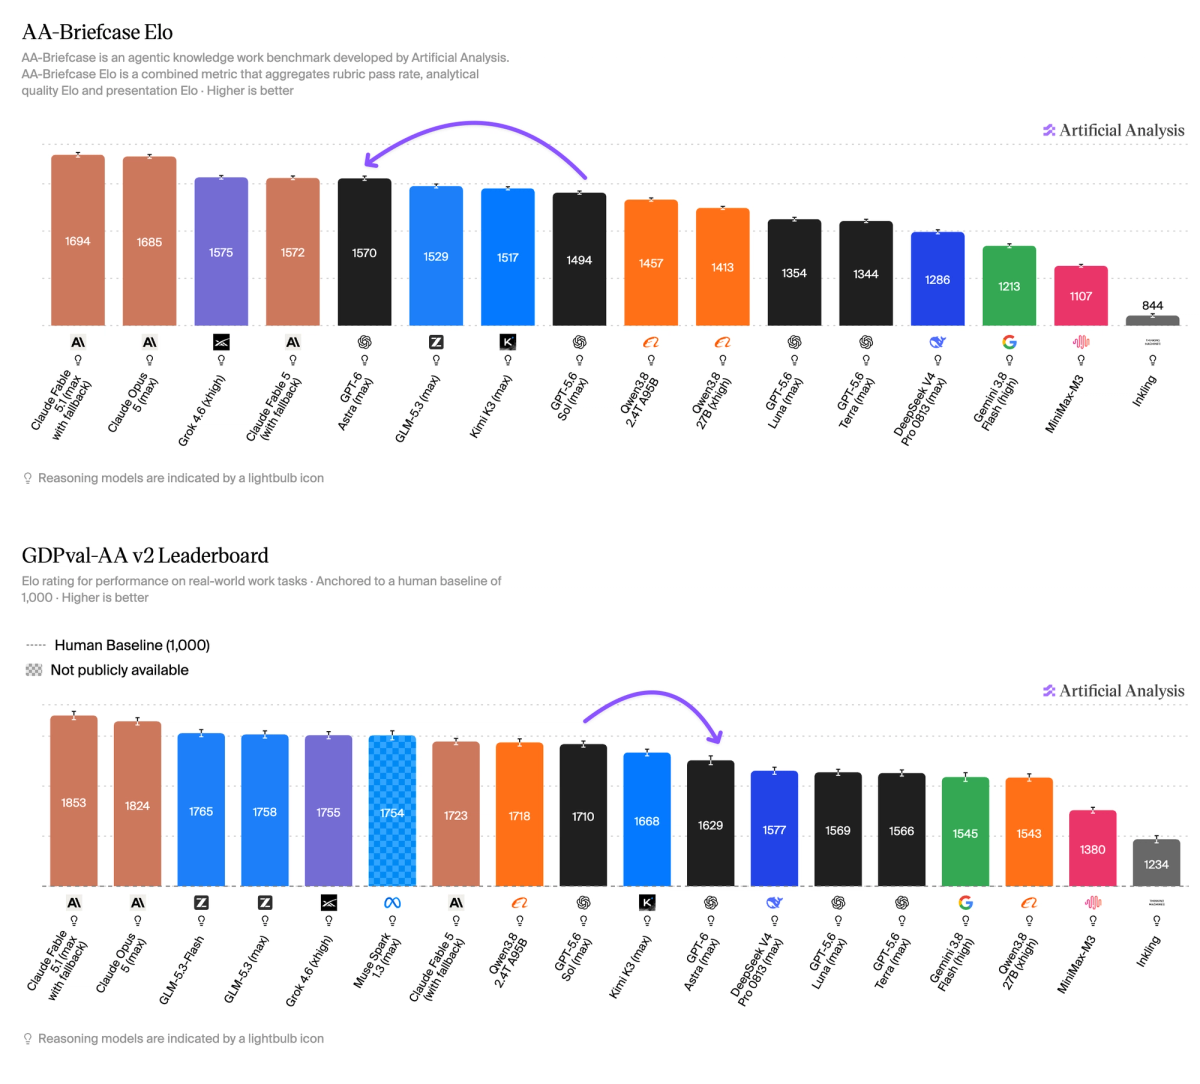
- Astra gagne 6 points sur Humanity’s Last Exam, fait chuter son taux d’hallucination de 92 % à 51 % sur AA-Omniscience et progresse d’environ 80 points d’Elo sur AA-Briefcase, l’évaluation de travail intellectuel au long cours.
- Dans l’autre sens, il perd environ 80 points d’Elo sur GDPval-AA v2, adapté d’un jeu de données d’OpenAI qui mesure des tâches économiquement utiles réparties sur 44 métiers, et recule de 2 à 3 points sur le support client, le code scientifique et le raisonnement en contexte long.
- Fable 5.1 mène justement GDPval-AA v2 à 1 853 points d’Elo, même si son avance sur Opus 5 tient dans l’intervalle de confiance. Si vous confiez des analyses de fond à un modèle, les cinq points d’écart ne sont pas anodins et la qualité des outputs s’en ressentiront ; à l’inverse, si vous automatisez des tâches répétées et cadrées, ils ne changeront presque rien.
Code et agents : l’écart se joue sur les tokens, pas sur le score
Si votre équipe fait tourner un agent de code toute la journée, ceci devrait vous intéresser :
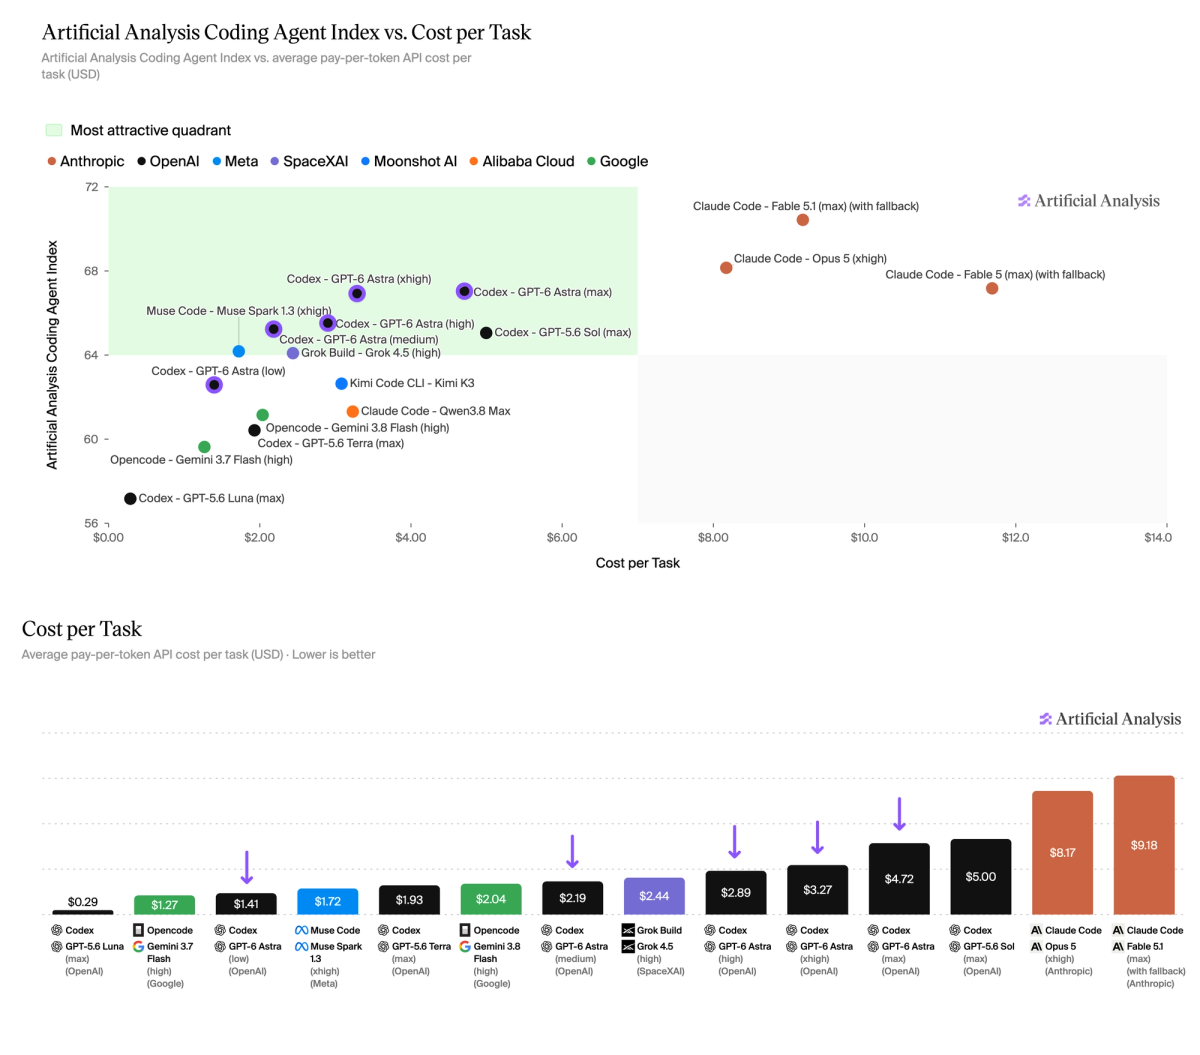
- Sur le Coding Agent Index d’Artificial Analysis, Fable 5.1 exécuté dans Claude Code mène avec 70 points. Astra dans Codex obtient 67, à peu près le niveau de Claude Opus 5, de Claude Fable 5 et de Muse Spark 1.3 de Meta.
Concrètement, le rattrapage d’OpenAI passe surtout par le fait qu’Astra consomme un tiers des tokens de GPT-5.6 Sol à effort maximal dans le harnais Codex, et un cinquième de ceux de Claude Opus 5. Une tâche de cet index lui revient donc à moins de la moitié du prix de Claude Fable 5 pour un score identique.
Attention toutefois : sur ce même index, OpenAI publie 67,0 pour Astra et 67,2 pour Fable 5.1, sans préciser le harnais utilisé, quand Artificial Analysis mesure 70 pour Fable 5.1 dans Claude Code. Le résultat d’un agent dépend autant de son environnement d’exécution que du modèle, et c’est vrai aussi pour les outils de vibe coding que vous testez en interne.
Les mesures maison d’OpenAI donnent Astra devant sur Terminal-Bench 4.0 (57,9 % contre 55,8 %) et sur DeepSWE v1.1 (74,1 % contre 67,4 %).
Sur FrontierCode 1.1, les deux modèles se tiennent en un ou deux points, avec Claude Fable 5 et Claude Opus 5 dans le même mouchoir de poche.
Pilotage d’ordinateur et travail de bureau : l’avantage à Astra ?
L’écart le plus net est observé sur le benchmark ScreenSpot-Pro, qui mesure la capacité à viser le bon élément dans une interface, OpenAI relève 92,7 % pour Astra contre 87,3 % pour Claude Fable 5, faute de score publié pour Fable 5.1.
Sur AutomationBench, 41,4 % contre 31,4 % pour Fable 5.1.
Sur BenchCAD, 95,9 % contre 84,3 %.
Attention toutefois à l’interprétation de ces scores : OpenAI précise que les scores Claude sur ScreenSpot-Pro proviennent de Mythos, la version de Fable dotée de moins de garde-fous, que les résultats Claude sur BenchCAD reflètent trois modifications de l’évaluation, et que Fable 5.1 n’a tout simplement pas de score publié sur Agents’ Last Exam ni sur OSWorld 2.0.
En clair : sur le pilotage d’interface, Astra a une avance réelle, mais elle est mesurée par l’un des deux concurrents, avec des réglages qu’il a choisis. Donc faites vos propres tests et comparatifs sur vos propres cas d’usages avant de préférer l’un ou l’autre.
Sur l’Elo de qualité de présentation d’AA-Briefcase, Astra reste loin derrière Fable 5.1 plus de 100 points Elo d’acrat entre les deux modèles. Le modèle qui sort aujourd’hui le livrable le plus présentable reste donc Fable 5.1 et GPT-6 Astra se fait même déjà détrôné par Grok 4.6 alors même que Musk a annoncé Grok 4.7 pour mi-septembre.
Notre verdict :
Aucun des deux modèles ne gagne le match dans son ensemble. Ceci dit, Claude Fable 5.1 tient l’intelligence générale, le développement web, le travail créatif et le travail analytique, GPT-6 Astra tient le pilotage d’interface et divise le coût par tâche par deux. Pour la plupart des équipes, la décision se jouera sur un paramètre que personne ne met en avant : la lecture de cache à 0,25 dollar chez Anthropic contre 1 dollar chez OpenAI, sur un agent qui relit le même contexte toute la journée. Et rappelez-vous qu’aucuns benchmarks ne remplacent vos propres tests sur vos propres cas d’usages.