Chaque équipe data finit par écrire les mêmes scripts : extraire les commandes de Shopify, les contacts de HubSpot, les tables d’une base MySQL, puis les recharger chaque nuit dans un entrepôt. Airbyte industrialise ce travail. Né en 2020 chez Y Combinator, l’outil a fait de l’open source son levier : la communauté maintient une partie des connecteurs, dont le catalogue dépasse aujourd’hui 700 sources et destinations.
Quel problème Airbyte règle, et pour qui
Airbyte est un outil d’ELT : il extrait les données d’une source, les charge telles quelles dans une destination (Snowflake, BigQuery, Databricks, un lac de données ou une base vectorielle), et laisse la transformation à l’entrepôt, avec dbt ou du SQL. Il ne nettoie pas vos données à votre place : pour cette étape, notre sélection d’outils de data cleaning reste utile.
Il vise d’abord les ingénieurs et analystes data qui alimentent un entrepôt depuis des dizaines d’outils SaaS et de bases. Il parle aussi aux équipes marketing et commerciales par sa fonction d’activation, qui renvoie des données modélisées vers le CRM ou l’outil d’emailing. L’éditeur pousse aussi un troisième usage : servir de couche de contexte aux agents IA, via un serveur MCP en bêta ouverte.
Comment fonctionne une synchronisation
Tout repose sur la connexion, qui relie une source à une destination. La documentation décrit un parcours en quatre temps :
- Vous configurez la source (identifiants d’API, accès à la base) et la destination à partir du catalogue de connecteurs.
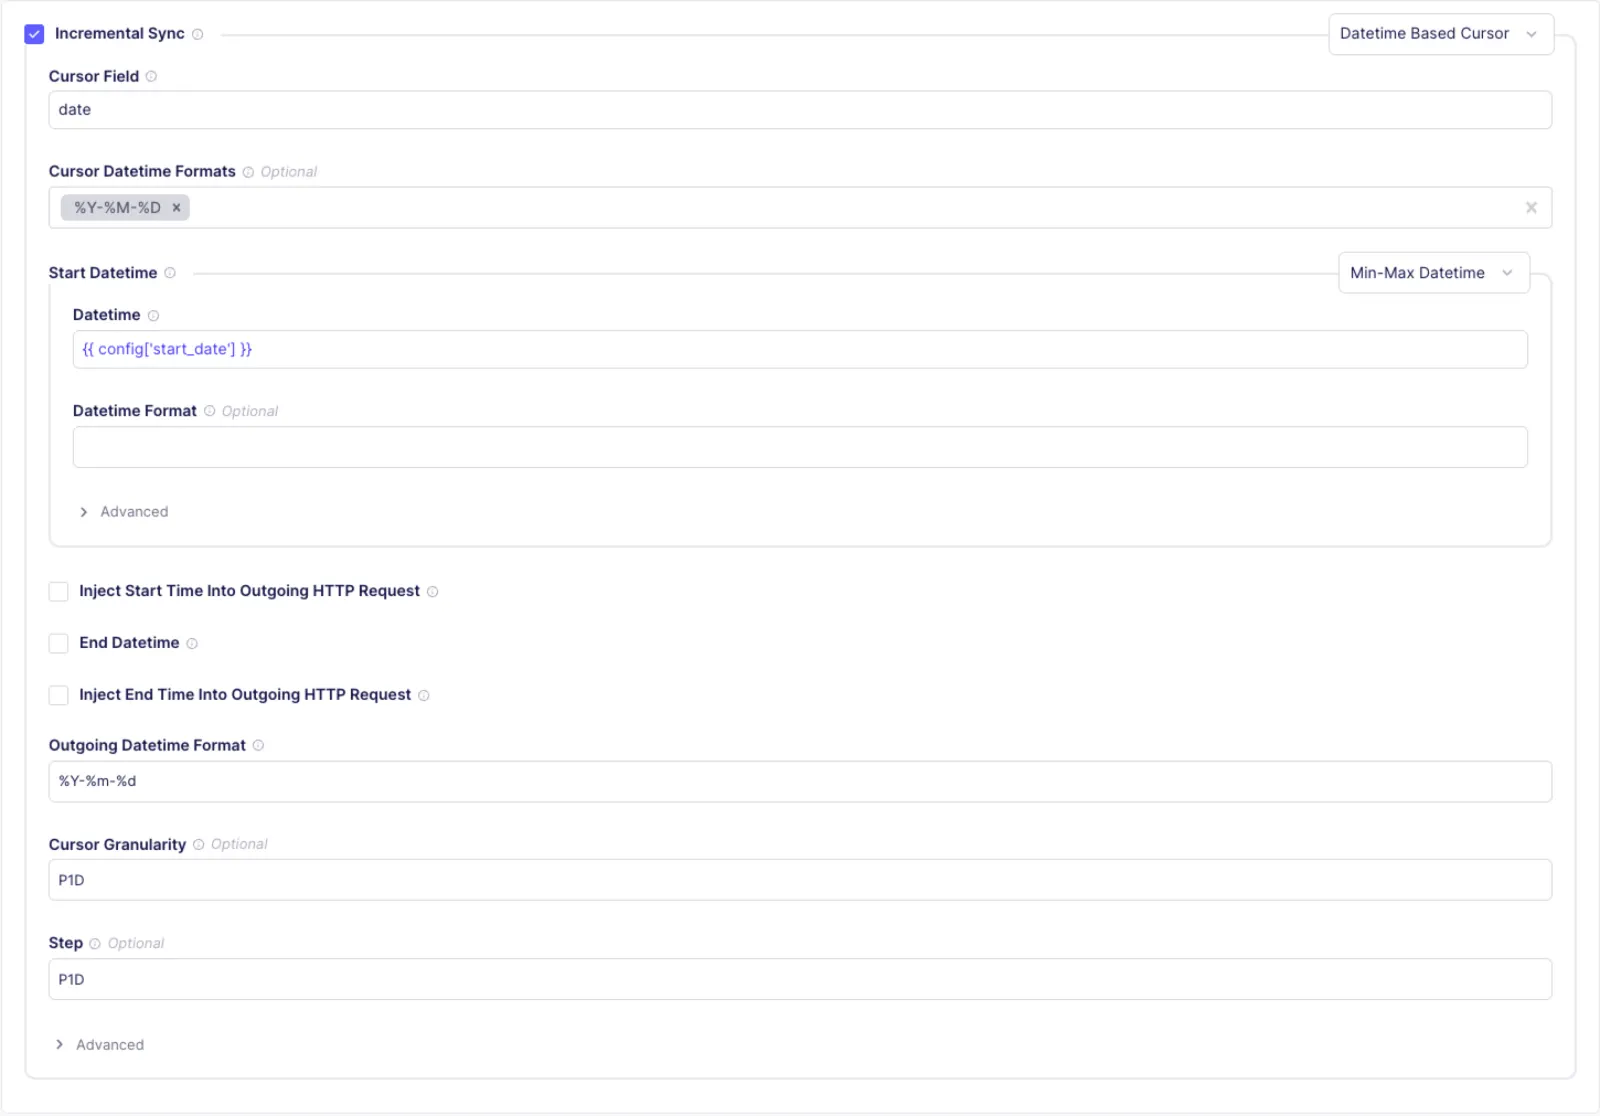
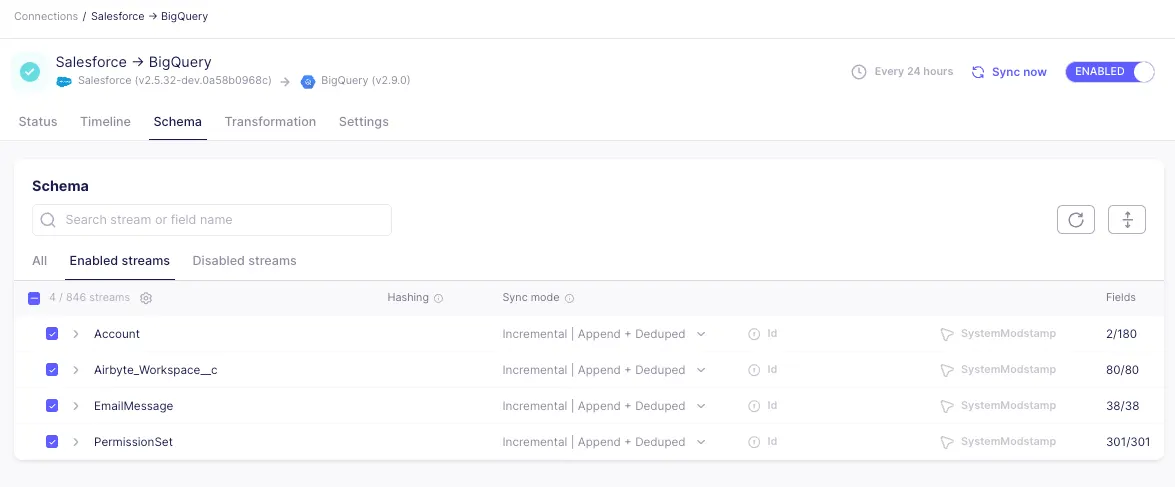
- Dans l’onglet Schema, vous choisissez les flux et les champs à copier, et le mode de synchronisation : rafraîchissement complet ou incrémental, avec ou sans dédoublonnage.
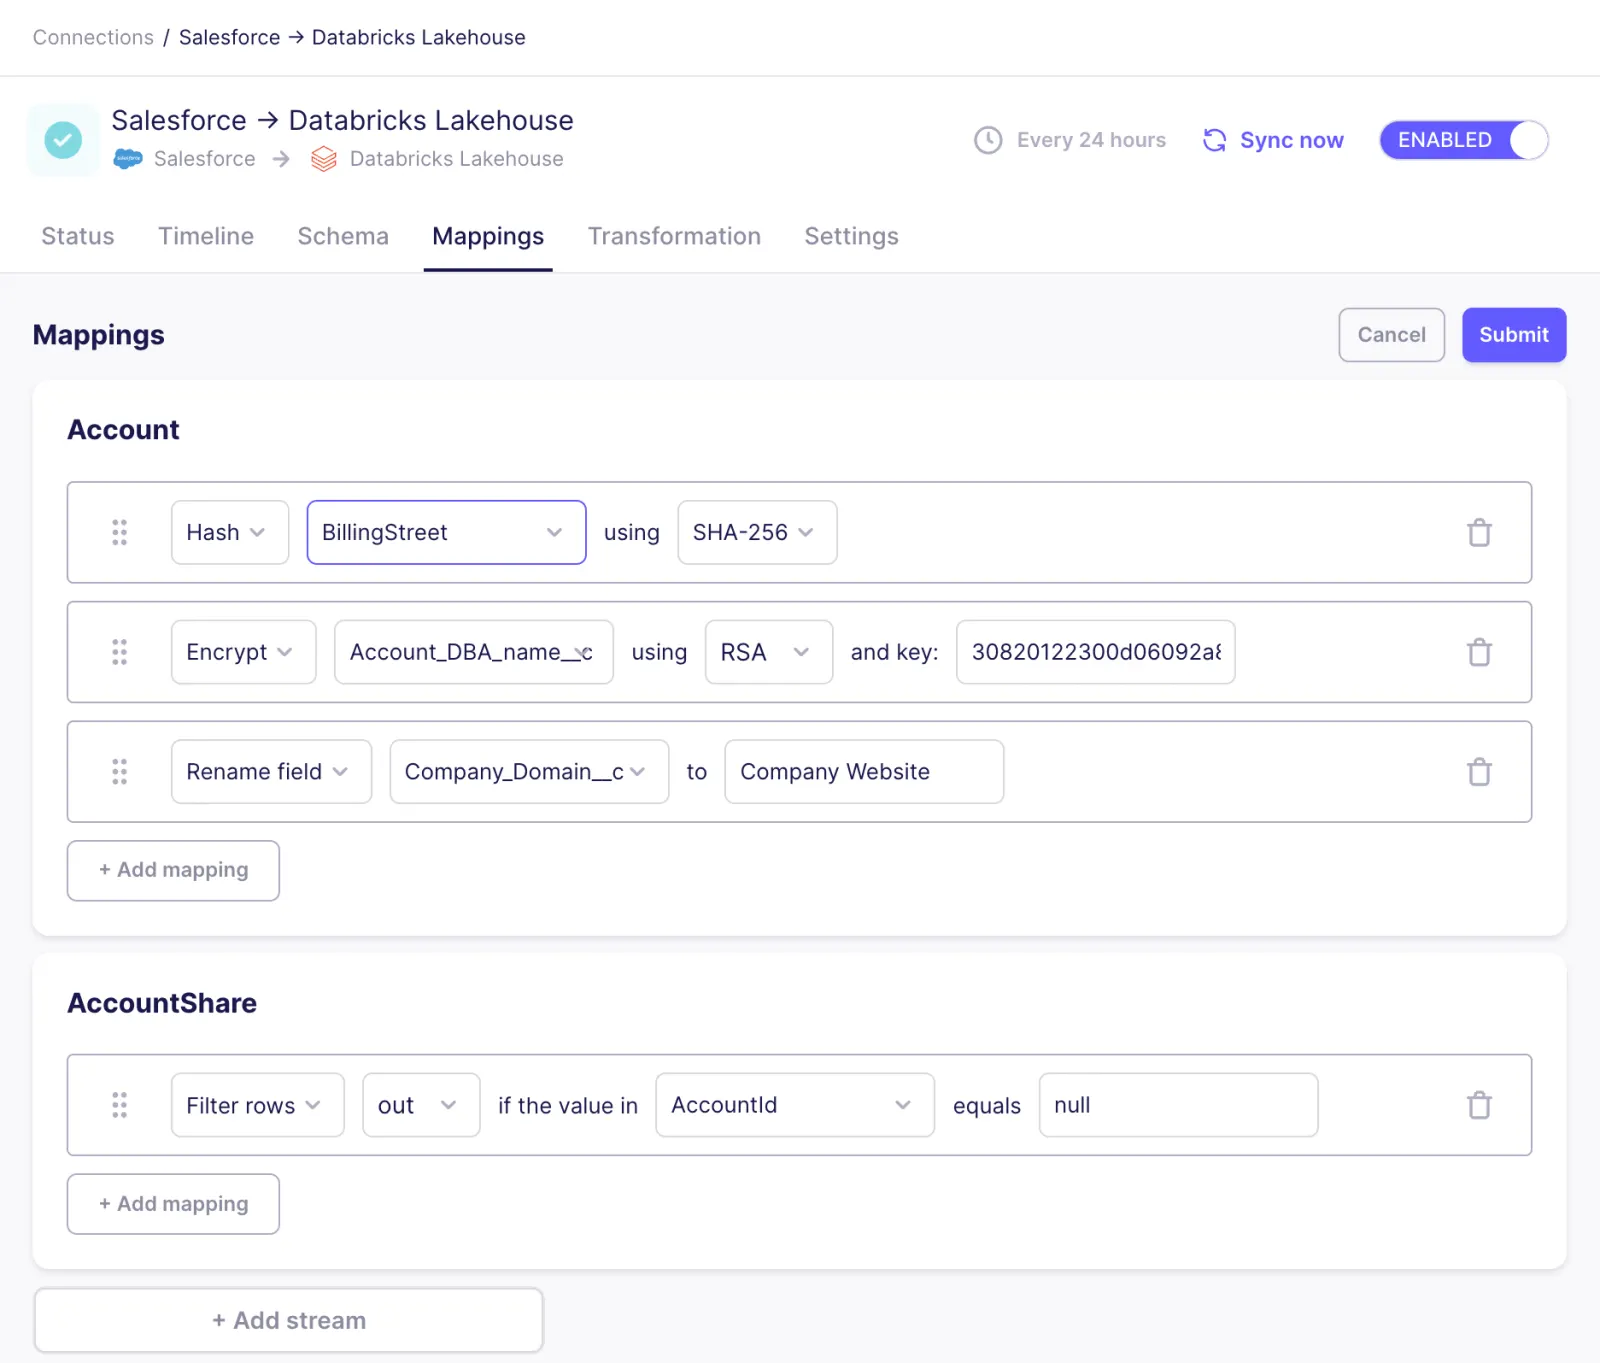
- Vous fixez la fréquence (toutes les 24 heures, toutes les 6 heures, ou une expression cron) et, si besoin, des mappings qui hachent, chiffrent, renomment ou filtrent des champs avant l’écriture.
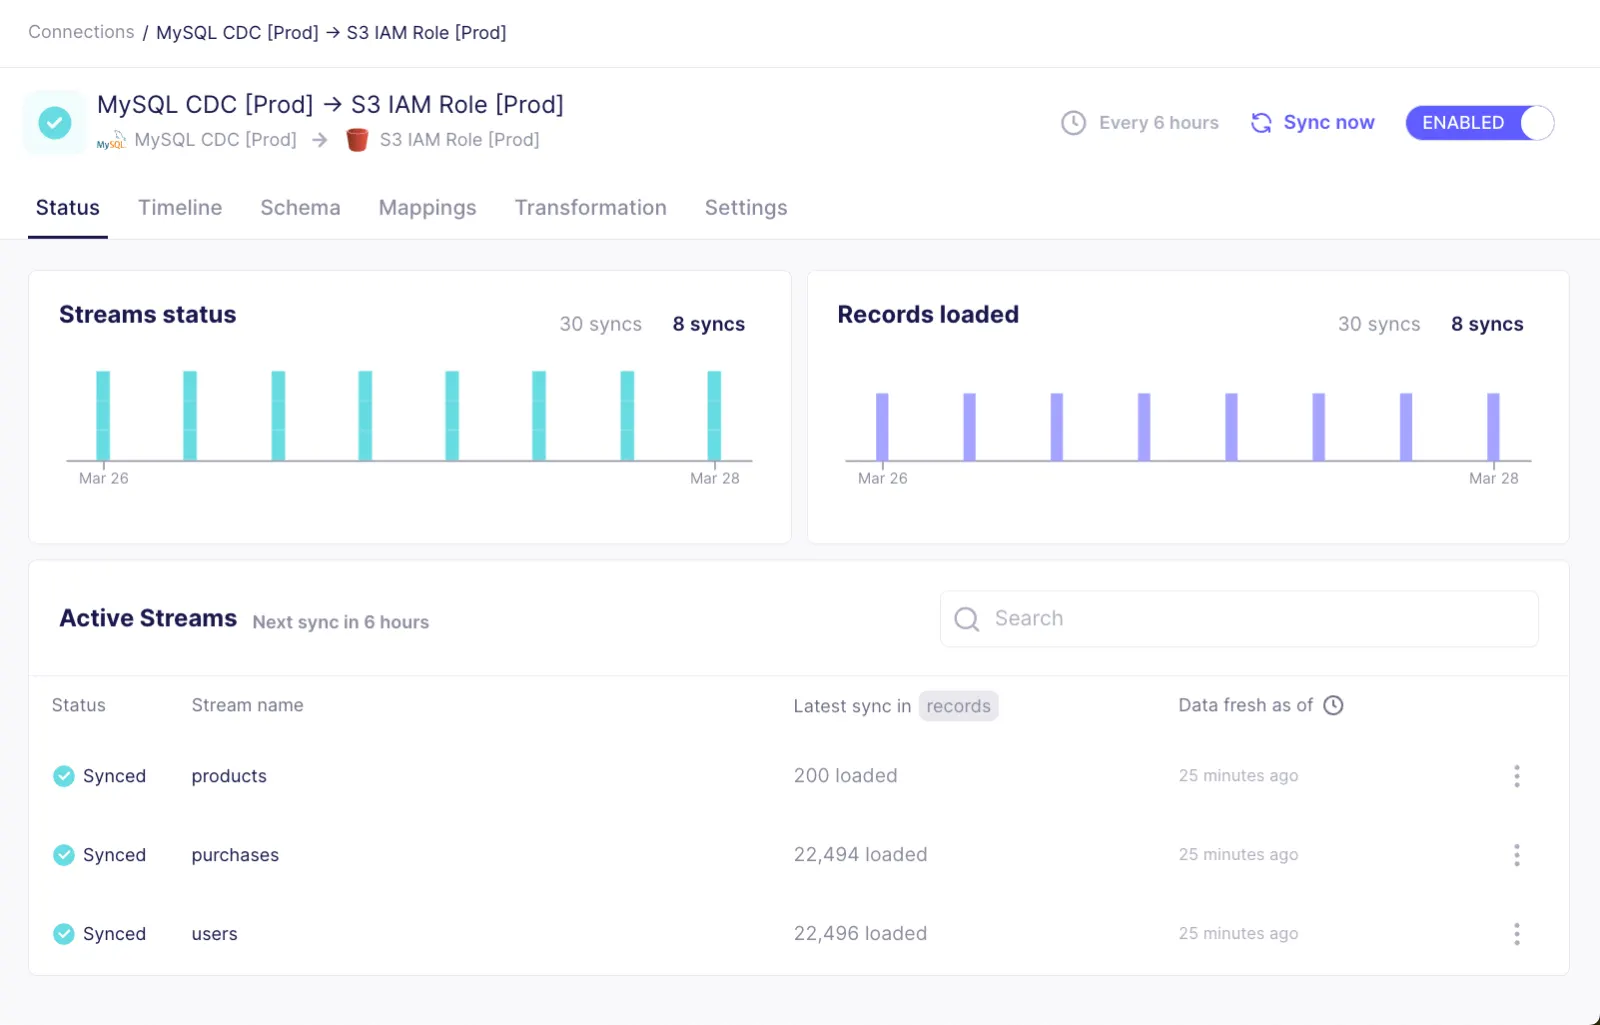
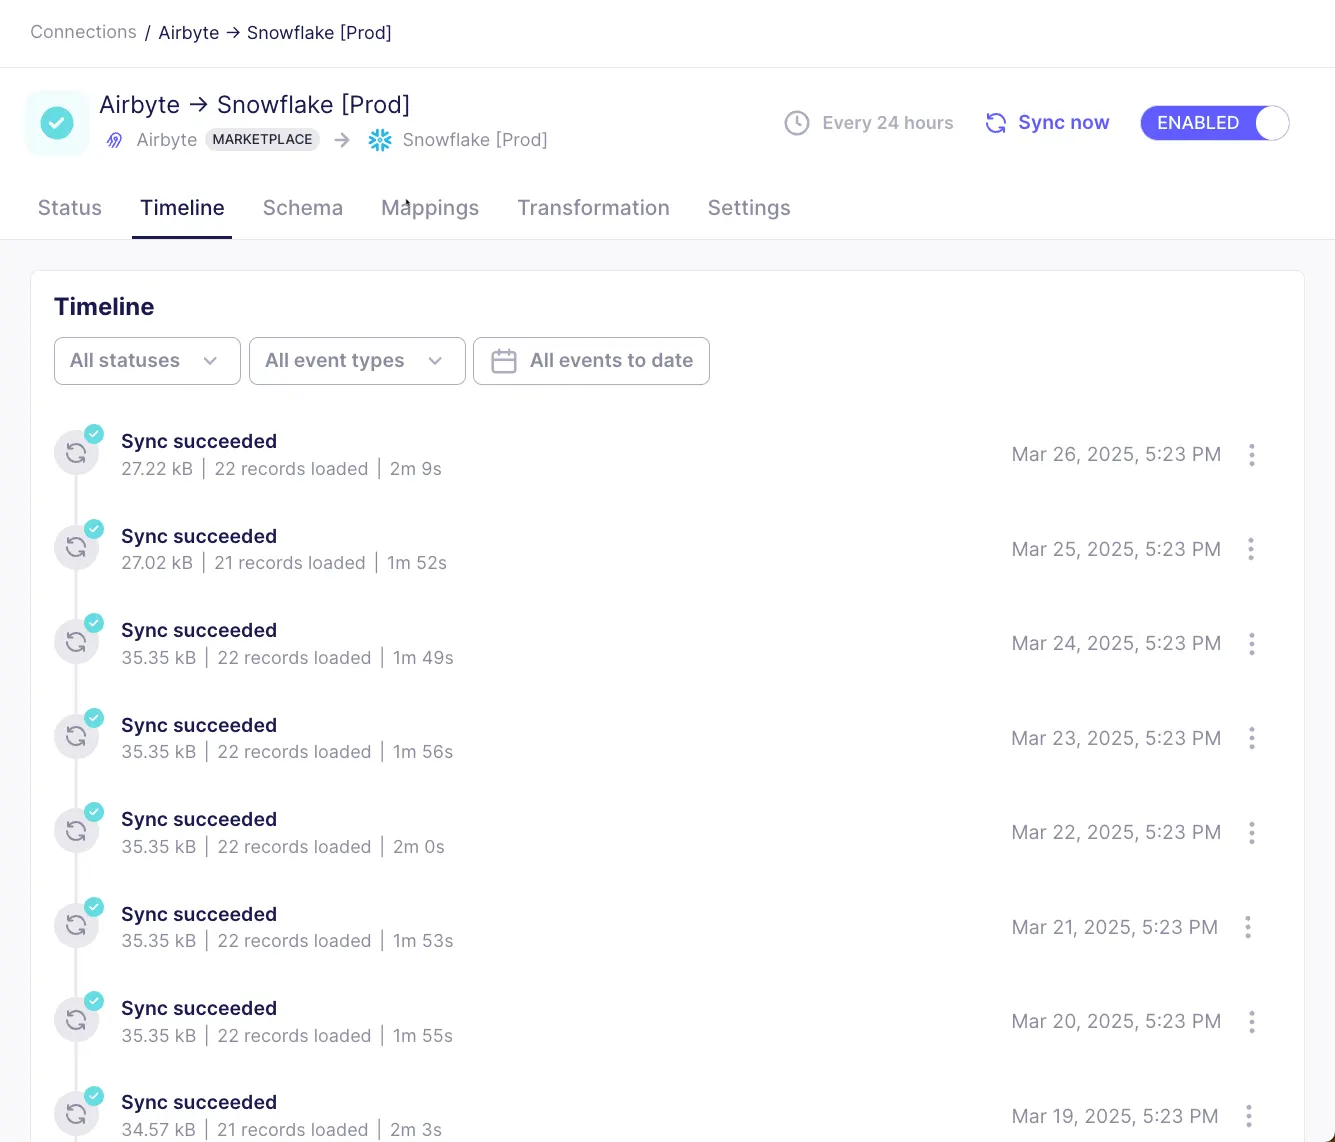
- Les onglets Status et Timeline suivent ensuite chaque exécution : flux synchronisés, nombre d’enregistrements chargés, durée et erreurs.
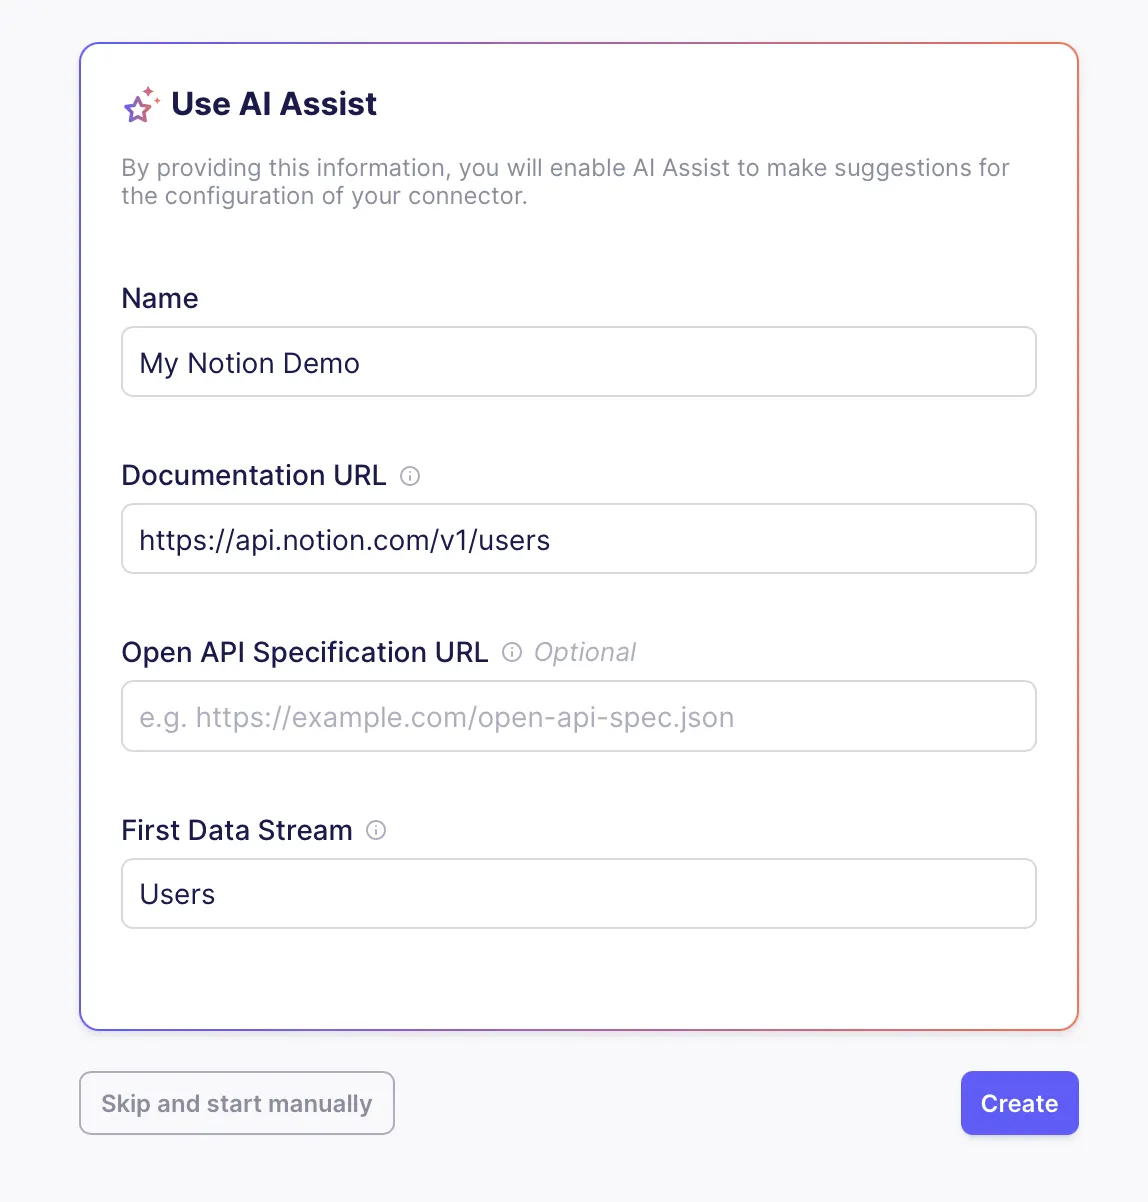
Pour les bases de données, la capture des changements (CDC) ne recopie que les lignes ajoutées, modifiées ou supprimées. Si votre source n’existe pas dans le catalogue, le Connector Builder génère un connecteur à partir de la documentation d’une API, en formulaires ou en YAML, avec un assistant IA qui propose la configuration. Les profils développeurs peuvent tout piloter en code : API, fournisseur Terraform, bibliothèque Python PyAirbyte et intégrations Airflow, Dagster ou Prefect.
Cas d’usage concrets selon votre profil
- Analyste dans une PME e-commerce : rassembler Shopify, Stripe et Google Ads dans BigQuery, puis brancher un outil de BI comme Tableau sur des tables à jour chaque matin.
- Équipe data d’une scale-up : répliquer en CDC une base de production MySQL ou PostgreSQL vers Snowflake sans charger le serveur, avec des synchronisations rapprochées.
- Équipe marketing : renvoyer des scores d’engagement calculés dans l’entrepôt vers les propriétés de contact HubSpot ou Braze pour cibler les campagnes.
- Entreprise soumise à des contraintes de souveraineté : garder les données dans son propre cloud ou ses serveurs avec le déploiement hybride, tout en confiant l’interface de pilotage à Airbyte.
Une fois les données centralisées, la restitution passe par un outil de visualisation : notre comparatif des outils de data visualisation aide à choisir la couche suivante.
Airbyte face à Fivetran, Stitch et n8n
Fivetran est l’alternative la plus citée. Entièrement géré et propriétaire, il mise sur des connecteurs maintenus par l’éditeur et une mise en route sans infrastructure. Airbyte se distingue par sa version auto-hébergeable gratuite et par la possibilité d’écrire ou de modifier un connecteur soi-même. Stitch couvre un besoin voisin, lui aussi sous forme de service géré.
Il ne faut pas confondre Airbyte avec un automate de workflows comme n8n : ce dernier déclenche des actions entre applications, enregistrement par enregistrement, quand Airbyte déplace des tables entières à intervalle régulier vers un entrepôt. Les deux se complètent souvent, et notre catégorie logiciels d’automatisation recense les autres options.
Les limites à connaître avant de vous lancer
- La facturation cloud des plans Standard et Plus dépend du volume : 6 crédits par million de lignes pour une API, 4 crédits par Go pour une base ou des fichiers. Une resynchronisation complète consomme autant qu’un premier chargement.
- Les crédits épuisés ne coupent pas les synchronisations : la consommation supplémentaire est facturée en fin de mois, ce qui impose de surveiller l’usage.
- La version Core s’installe en ligne de commande, sur un cluster Kubernetes créé par Docker, et demande 4 processeurs et 8 Go de mémoire pour de bonnes performances.
- Le support humain répond de 7 h à 19 h, heure de la côte Est américaine ; les utilisateurs de Core n’y ont pas accès.
- Le Connector Builder ne crée que des sources, jamais des destinations.
Comment choisir votre plan
Si votre équipe sait administrer un serveur, commencez par Core : c’est gratuit et vous gardez la main sur l’hébergement. Si vous préférez ne rien installer, Standard convient aux premiers pipelines à faible volume, avec des synchronisations au mieux horaires. L’éditeur conseille de passer à Plus au-delà de 40 crédits par mois : le forfait revient alors moins cher et ajoute le SSO, des synchronisations toutes les 15 minutes et un délai de réponse garanti de 24 heures.
Pro et Enterprise Flex changent de logique : le prix dépend des Data Workers réservés, des unités de calcul qui exécutent chacune environ trois synchronisations à la fois, et non plus du volume. Ils se justifient quand vos volumes fluctuent fortement ou que vos données ne doivent pas quitter votre infrastructure. Profitez de l’essai de 14 jours et de ses 400 crédits pour mesurer votre consommation réelle avant de choisir.