


Quand une application répond lentement, la question n’est presque jamais « est-ce que ça marche ? » mais « où ça coince ? » : dans le code, la base de données, un conteneur Kubernetes saturé ou le navigateur de l’utilisateur. Dynatrace s’adresse aux équipes qui doivent répondre à cette question sur des centaines, voire des milliers de serveurs. Cet article explique sa logique de fonctionnement, les profils qui en tirent le plus, sa place face à Datadog, New Relic et Grafana, puis la manière d’aborder son modèle de facturation à la consommation.
Quel problème Dynatrace règle, et pour qui
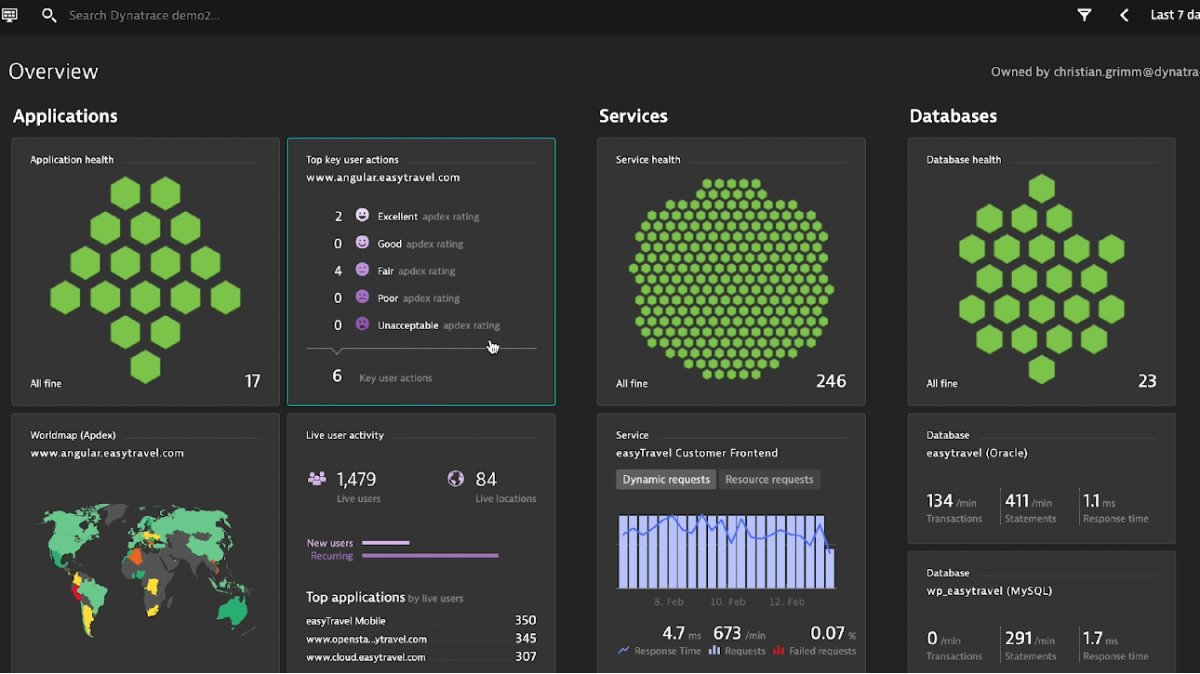
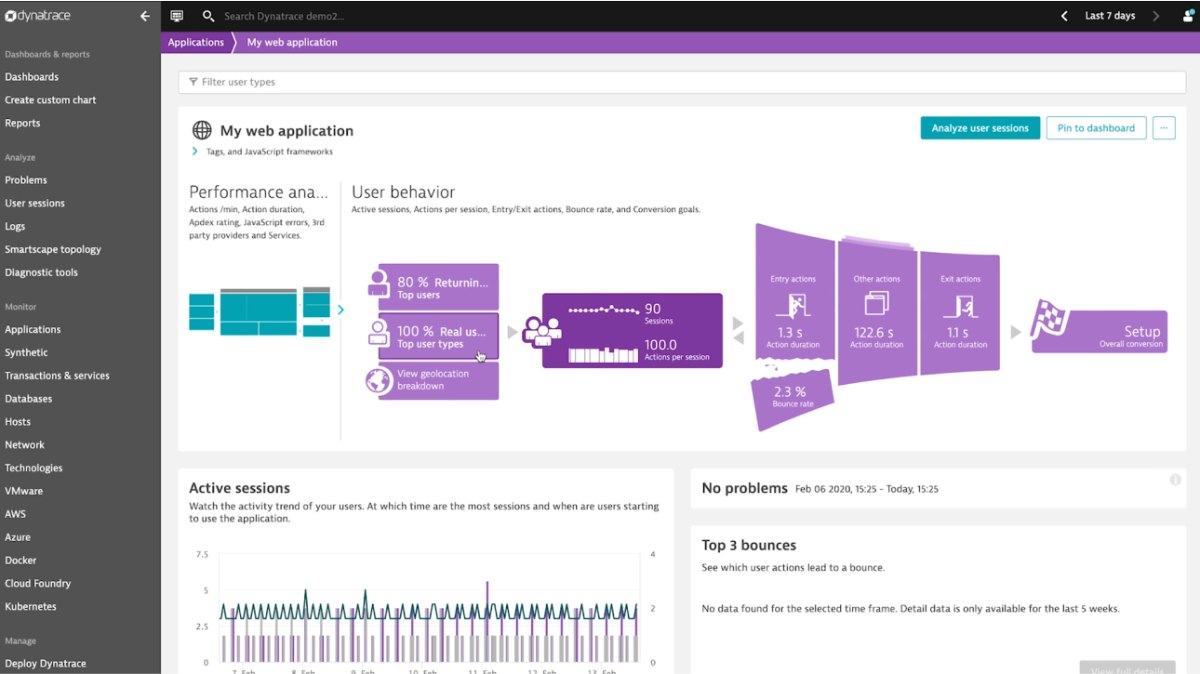
Dans un système d’information moderne, un même incident laisse des traces partout : une métrique de CPU qui grimpe, des lignes d’erreur dans les logs, une trace distribuée qui s’allonge, des sessions utilisateur qui décrochent. Les outils de supervision classiques collectent ces signaux séparément et laissent l’équipe d’astreinte faire le lien à la main. Dynatrace part du principe inverse : stocker tous ces types de données au même endroit et cartographier en continu les dépendances entre services, pour que l’analyse des causes se fasse sur un modèle déjà connu de l’architecture.
L’éditeur revendique des milliers de salariés et des équipes réparties sur une cinquantaine de sites dans le monde. Sa cible est clairement la moyenne et la grande entreprise : la page d’accueil française met en avant des références comme Air France-KLM ou EDF, et le contrat repose sur un engagement de dépense annuel. Si votre besoin se limite à savoir si votre site répond, un service de ping comme UptimeRobot suffira largement : notre guide pour surveiller la disponibilité d’un site web détaille ces options plus légères.
Comment fonctionne la plateforme
La documentation décrit une architecture en quelques briques, à comprendre avant de lancer un essai :
- OneAgent : un agent unique installé une fois par hôte, qui découvre les processus et collecte en continu métriques, traces et logs, sans instrumentation manuelle application par application ;
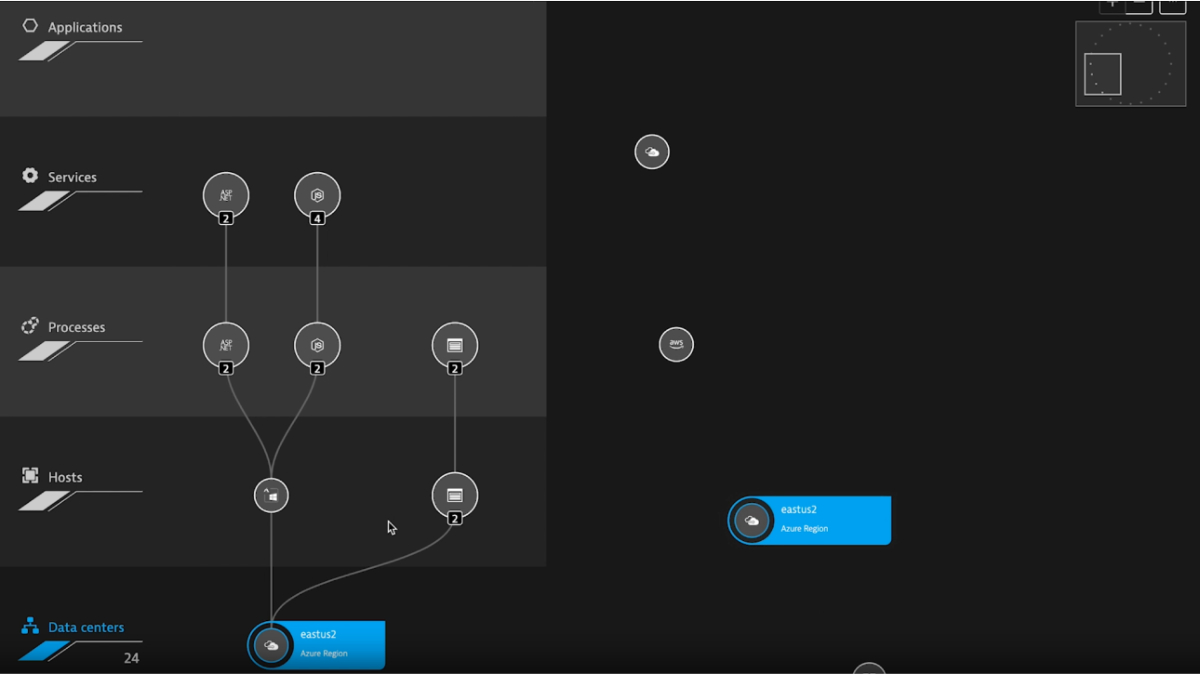
- Smartscape : la cartographie automatique des relations entre applications, services, processus et infrastructure, qui sert de contexte à toutes les analyses ;
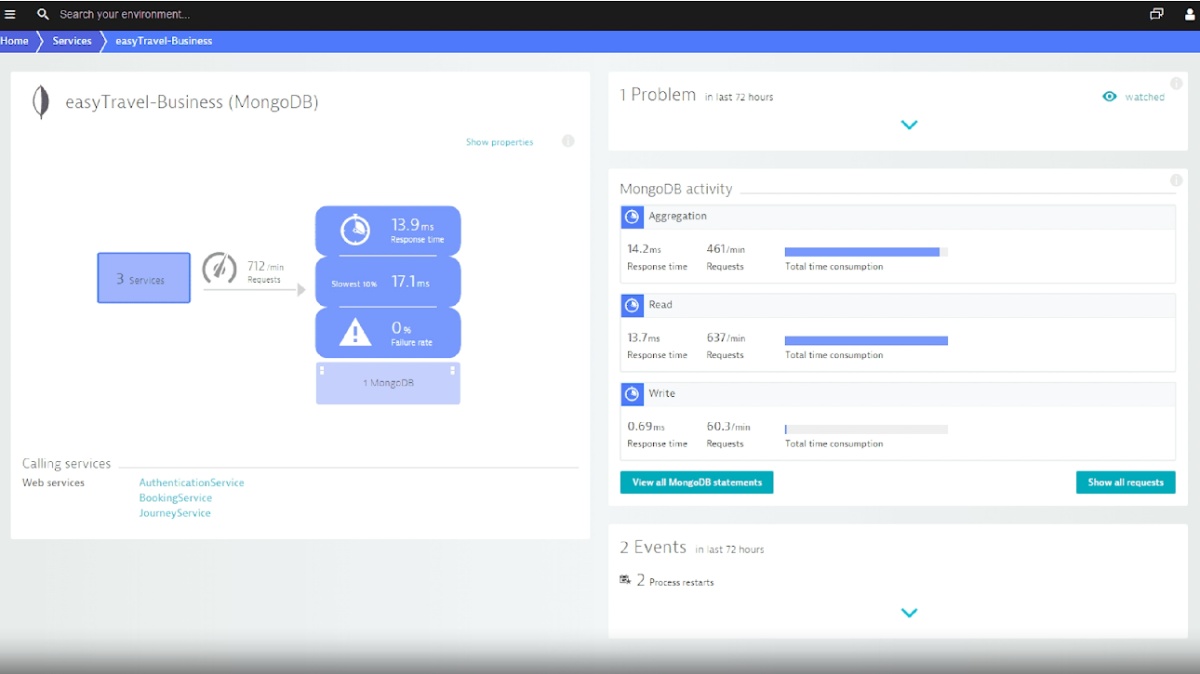
- Grail : le lac de données de la plateforme, sans index et lu au moment de la requête, où logs, métriques, traces, événements et données métier sont interrogés avec le langage DQL ;
- Dynatrace Intelligence : la couche d’IA qui détecte les anomalies, remonte à la cause racine et, avec Dynatrace Assist, traduit une question en langage naturel en requête DQL ;
- AutomationEngine et AppEngine : des workflows pour déclencher une remédiation et un environnement pour développer des applications internes sur les mêmes données.
Concrètement, un essai démarre par l’installation de OneAgent sur quelques hôtes ou par l’opérateur Kubernetes. L’éditeur annonce une mise en route en cinq minutes environ pour l’essai de 15 jours, et propose aussi un Playground public, alimenté par des données de démonstration, pour explorer l’interface sans rien installer. Comptez en revanche davantage de temps pour maîtriser DQL, construire des tableaux de bord adaptés à chaque équipe et régler les seuils d’alerte : la documentation et les parcours de Dynatrace University sont là pour ça.
Deux modes d’hébergement coexistent. La version SaaS concentre les nouveautés (Grail, Dynatrace Intelligence, AppEngine). Dynatrace Managed s’installe sur vos propres serveurs, avec au moins trois nœuds en production, pour les organisations qui ne peuvent pas envoyer leurs données de supervision dans un cloud tiers.
Cas d’usage concrets selon votre équipe
- Équipe SRE ou d’exploitation : réduire le délai de résolution des incidents en partant d’un problème déjà corrélé (services touchés, cause probable, utilisateurs impactés) plutôt que d’une avalanche d’alertes. Coca-Cola HBC, cité par l’éditeur, fait état d’un MTTR réduit de 30 %.
- Équipe de développement : suivre une transaction de bout en bout, du clic dans le navigateur à la requête SQL, et descendre jusqu’au profilage du code sur le plan Full-Stack.
- Plateforme Kubernetes : superviser clusters, pods et conteneurs avec le même agent, la supervision de la plateforme Kubernetes étant incluse sur les hôtes Full-Stack.
- Équipe e-commerce ou produit : mesurer l’expérience réelle des visiteurs avec le Real User Monitoring et le Session Replay, et simuler des parcours d’achat avec les moniteurs synthétiques, utile en complément d’un travail pour réduire le temps de chargement d’un site WordPress.
- Équipe sécurité : repérer les vulnérabilités réellement exploitées en production grâce à l’analyse à l’exécution, en complément des logiciels de sécurité informatique plus classiques.
Dynatrace face à Datadog, New Relic et Grafana Cloud
Les quatre plateformes couvrent un périmètre comparable (APM, infrastructure, logs, expérience utilisateur), mais avec des philosophies différentes.
| Outil | Approche | À privilégier si |
|---|---|---|
| Dynatrace | Agent unique, cartographie automatique des dépendances, analyse des causes par IA | Vous gérez un parc important et voulez des incidents déjà corrélés |
| Datadog | Produits d’observabilité activés à la carte, tableaux de bord à composer | Vous préférez assembler vous-même les briques et les tableaux de bord |
| New Relic | Plateforme d’observabilité généraliste, pensée pour un démarrage rapide | Votre équipe est réduite et veut commencer sans contrat annuel |
| Grafana Cloud | Écosystème open source (Prometheus, Loki, Tempo) en version hébergée | Vous utilisez déjà ces briques et voulez garder la main sur la configuration |
Le choix se joue moins sur la liste des fonctions que sur la quantité de travail que vous acceptez de faire. Dynatrace automatise davantage la découverte et la corrélation, au prix d’un modèle plus fermé et d’un ticket d’entrée contractuel. Les stacks open source demandent plus d’effort d’intégration, mais restent plus souples sur les petits volumes. Un argument propre à Dynatrace pèse dans les grandes équipes : aucun coût par utilisateur, chacun accède à l’ensemble de la plateforme.
Les limites à connaître avant de vous lancer
- Un budget difficile à prévoir : chaque capacité a son propre compteur (heure d’hôte, GiB de mémoire, GiB de logs ingérés, jour de rétention, session, requête synthétique, unité d’IA). Une estimation sérieuse suppose de connaître précisément votre parc et vos volumes.
- Un engagement annuel : le contrat Dynatrace Platform Subscription repose sur un montant minimal de dépense annuelle, dont la valeur n’est pas publiée.
- Une courbe d’apprentissage réelle : l’étendue de la plateforme et le langage DQL demandent un temps de formation, que Dynatrace University aide à structurer.
- Plus d’application mobile : les applications iOS et Android ont été retirées le 30 juin 2026 ; les alertes passent désormais par Slack, Teams, PagerDuty ou l’e-mail, et la consultation par l’interface web adaptée au mobile.
Comment aborder l’offre et le budget
Il n’y a pas de formule à cocher : vous choisissez, hôte par hôte, le niveau de supervision. Foundation & Discovery convient à l’inventaire et à la santé de base des serveurs, Infrastructure Monitoring ajoute l’analyse détaillée des processus, disques, mémoire et réseau, et Full-Stack Monitoring ouvre l’APM et le profilage du code. Réservez Full-Stack aux hôtes qui portent des applications critiques et gardez les autres en supervision d’infrastructure : c’est le levier le plus direct sur la facture, puisque Full-Stack est facturé à la mémoire de l’hôte.
Côté logs, comparez les deux modes publiés : le paiement à la requête convient si vous interrogez rarement vos journaux, l’offre avec requêtes incluses devient plus lisible dès que les équipes y cherchent au quotidien. Profitez enfin des 15 jours d’essai pour mesurer vos volumes réels (hôtes, sessions, GiB de logs) avant de négocier l’engagement annuel, et prévoyez de brancher les workflows de remédiation sur vos outils d’automatisation existants plutôt que de tout reconstruire.