Quand une marque interroge sa présence dans les réponses des IA génératives, elle mélange souvent deux questions distinctes. La première : dans quelles réponses apparaît-elle, spontanément, sans qu’on la nomme ? La seconde : quand elle est explicitement citée, comment est-elle décrite ? Ces deux questions relèvent de logiques différentes et appellent des méthodes de suivi différentes. Les confondre conduit à des conclusions erronées, dans un sens comme dans l’autre.
Deux types de questions, deux types de réponses
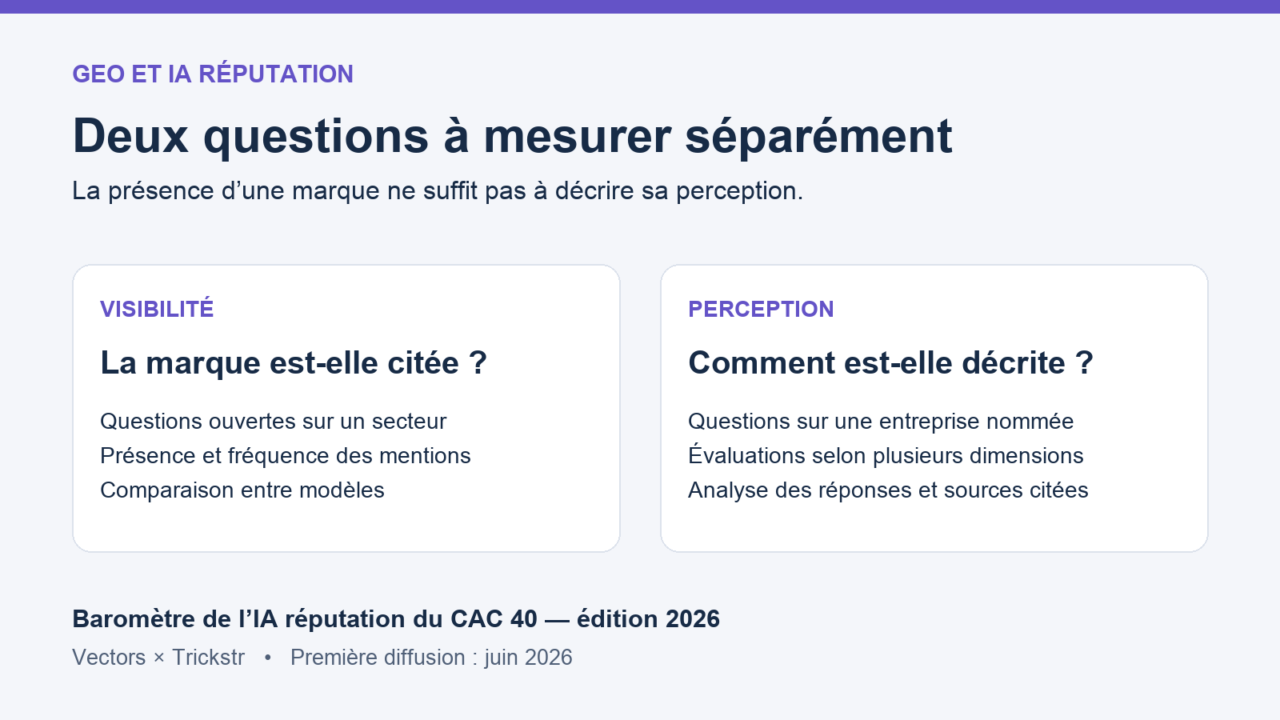
Une question ouverte sur un secteur, « quels sont les principaux fournisseurs d’équipements électriques industriels », teste la visibilité spontanée d’une marque : apparaît-elle dans la réponse sans y être invitée, aux côtés de quels concurrents, à quelle position dans l’énumération ? Une question portant sur une entreprise nommée, « que sait-on de Schneider Electric » ou « quelle est la réputation de cette entreprise », ne teste plus la visibilité, puisque la marque est déjà présente dans la question. Elle teste la perception : le ton employé, les faits mobilisés, les controverses éventuellement rappelées, les sources citées à l’appui.
Un même mot-clé de marque peut ainsi produire deux diagnostics différents mais complémentaires si l’on ne sépare pas ces deux angles : une entreprise peu visible dans les réponses ouvertes sur son secteur peut être décrite de façon très factuelle et neutre dès qu’elle est nommée, et inversement.
Être bien perçu sans être souvent cité
Il découle de cette distinction qu’une marque peut être bien évaluée par les modèles sans apparaître fréquemment dans les réponses spontanées. La fréquence de citation peut dépendre du secteur, du nombre d’acteurs comparables et de la formulation des questions ouvertes. La teneur de la description peut notamment dépendre des informations mobilisées, du modèle interrogé et de la formulation de la question. Une entreprise peu citée spontanément mais bien documentée par des sources factuelles peut obtenir une perception favorable dès qu’elle est nommée directement. Ce constat invite à ne pas réduire le suivi GEO, Generative Engine Optimization, ou optimisation de la visibilité dans les moteurs génératifs, à un seul indicateur de fréquence d’apparition.
Les précautions méthodologiques à respecter
Mesurer ces deux dimensions de façon comparable suppose plusieurs précautions. Les questions doivent être formulées de manière neutre, sans orienter la réponse vers un jugement positif ou négatif.
Les questions doivent être répétées, car les modèles peuvent produire des réponses différentes à une même interrogation. La formulation exacte, le contexte et les paramètres doivent être enregistrés pour réutiliser le protocole et documenter les conditions de chaque collecte. Les modèles et les informations disponibles évoluent : cela ne garantit donc ni des conditions ni des résultats identiques dans le temps. Les sources citées doivent être examinées, et pas seulement comptées. Elles indiquent les références affichées dans les réponses, sans démontrer à elles seules leur influence ni toutes les informations utilisées par le modèle. Enfin, les résultats doivent être présentés séparément par modèle : les modèles génératifs n’ont pas les mêmes sources d’entraînement ni les mêmes comportements, et agréger leurs réponses masque des écarts qui sont souvent l’information la plus utile.
Un exemple à grande échelle
Le Baromètre de l’IA réputation 2026 de Vectors et Trickstr, diffusée pour la première fois en juin 2026, illustre cette approche à l’échelle des entreprises du CAC 40. L’étude a administré près de 39 800 questions à quatre modèles d’IA générative, en évaluant les réponses sur neuf dimensions de réputation. Coproduite par Vectors et Trickstr, elle s’appuie sur PromptForge pour la collecte et l’analyse des réponses. Cet outil a été développé par Trickstr et intégré à la plateforme Kosmos.
Selon cette édition, Schneider Electric arrive en tête du classement de réputation. Ce résultat mesure la façon dont l’entreprise est décrite dans les réponses des modèles interrogés sur cette base méthodologique précise ; il ne constitue pas un jugement objectif sur la qualité de l’entreprise elle-même, et ne préjuge pas de sa visibilité spontanée dans des questions sectorielles plus larges.
Trois suivis à mener séparément
Une marque qui souhaite comprendre sa place dans les réponses des IA génératives gagne à distinguer trois suivis plutôt que d’en chercher un seul. La présence : apparaît-elle dans les réponses à des questions ouvertes sur son secteur, sans y être nommée ? La perception : comment est-elle décrite lorsqu’elle est explicitement citée ? Les sources citées : quelles références les modèles citent-ils, et sont-elles à jour et fiables ? Aucun de ces suivis ne remplace les deux autres, et aucun outil ne permet de garantir un résultat donné sur l’un ou l’autre, les modèles génératifs évoluant indépendamment des marques qu’ils décrivent. Mais pris ensemble, ces trois axes offrent une lecture plus fidèle de ce qui se joue réellement dans les réponses des IA, que la seule question, souvent posée seule, de savoir si une marque « apparaît » ou non.
Cet article a été rédigé par un partenaire invité dans le cadre d’un partenariat sponsorisé