Google a lancé Gemini 3.8 Flash le 2 septembre avec un argument imparable : plus intelligent que 3.7 Flash, à tarif identique et surtout avec des générations très rapides ! Voici ce qu’il faut savoir sur ce modèle.
L’essentiel en bref
- Premier sur 200 modèles en vitesse de génération avec 348 tokens par seconde, il affiche pourtant 17,7 secondes avant son premier token de réponse, contre une médiane de 3,39 secondes dans sa gamme de prix.
- Les 0,75 $ par million de tokens en entrée et 3,75 $ en sortie sont un tarif d’introduction. Il expire le 31 décembre 2026 et passe à 1,50 $ et 7,50 $ au 1er janvier 2027, selon la note de bas de page du billet officiel de Google.
- Google reconnaît que 3.8 Flash exécute davantage d’étapes de raisonnement et consomme plus de tokens aux niveaux d’effort élevés. Artificial Analysis mesure un coût par tâche allant de 0,24 $ à 0,58 $ selon le réglage, soit 2,4 fois d’écart pour le même modèle.
3.8 Flash arrive trois semaines après 3.7 Flash, et constitue la troisième sortie Flash en six semaines.
Le modèle est déjà accessible via l’API Gemini, Google AI Studio, Gemini Enterprise, Google Antigravity, et côté grand public dans l’app Gemini et dans AI Mode de Google Search pour les abonnés AI Pro et Ultra.
Premier au classement de vitesse, mais 13 secondes d’attente avant la première réponse ?
348,3 tokens par seconde : sur ce critère, Artificial Analysis place Gemini 3.8 Flash (high) premier sur 200 modèles évalués. Aucun modèle de raisonnement ne génère plus vite, ce n’est donc pas un simple argument marketing.
Ceci dit, le même modèle met 17,7 secondes à livrer son premier token de réponse, quand la médiane de sa catégorie de prix se situe à 3,39 secondes.
L’écart vient du temps de réflexion, comptabilisé dans la latence pour les modèles de raisonnement : avant d’écrire quoi que ce soit, 3.8 Flash réfléchit, et il réfléchit longtemps.
Le détail qui compte ? La variante en effort low ramène cette latence à 0,70 seconde, mais retombe à 40 d’indice, soit le niveau de Gemini 3.5 Flash sorti bien avant.
En clair ? Cela disqualifie le réglage haut pour tout ce qui est synchrone et visible par un utilisateur. Un chatbot de support, un assistant de recherche produit sur une fiche e-commerce, un copilote intégré dans une interface : votre visiteur regarde un indicateur de chargement pendant treize secondes avant le premier mot. Le nom « Flash » décrit le débit, plus le délai de réponse.
Le rapport intelligence/prix est le vrai argument de 3.8 Flash
Artificial Analysis positionne Gemini 3.8 Flash sur la frontière de Pareto de son graphique intelligence contre coût par tâche, dans le quadrant que la plateforme désigne comme le plus favorable.
Ce dernier modèle de Gemini se classe 28ème sur 200 en intelligence, 45ème sur 200 en coût, 1er sur 200 en vitesse de génération. Vous payez ainsi le tarif d’un modèle de milieu de gamme pour un niveau de raisonnement qui joue dans le tiers supérieur.
Les prix mesurés le confirment : 0,75 $ par million de tokens en entrée face à une médiane de 1,75 $, et 3,75 $ en sortie face à une médiane de 10,00 $ pour les modèles comparables. Avec 41 points d’indice contre une médiane de 24, l’écart de performance est plus large que l’écart de prix.
Voici quelques benchmarks mis en avant par Google qui illustrent ses capacités :
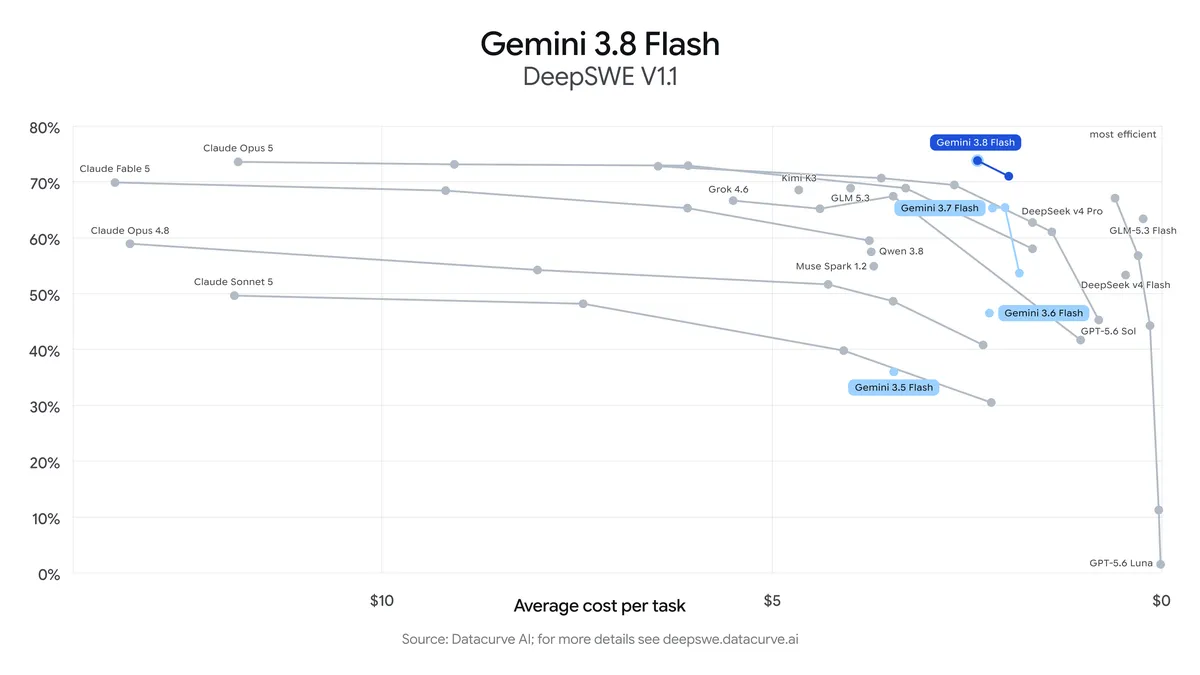
Sur DeepSWE v1.1, un benchmark d’ingénierie logicielle sur des missions longues, 3.8 Flash devance la plupart des modèles frontière plus coûteux que lui. Le graphique publié par l’éditeur place le modèle au-dessus de 70 % de réussite pour un coût par tâche nettement inférieur à celui de ses concurrents directs.
Attention toutefois à ce détail : le tarif actuellement affiché pour Gemini 3.8 Flash expire le 31 décembre 2026
En bas de l’article qui annonce le nouveau modèle, une note de trois lignes désamorce l’argument commercial de toute l’annonce : les 0,75 $ par million de tokens en entrée et les 3,75 $ en sortie sont un prix d’introduction valable jusqu’au 31 décembre 2026. Au 1er janvier 2027, la grille passe à 1,50 $ et 7,50 $.
Le prix va donc rapidement passer du simple au double (prenez-le donc en compte avant de l’intégrer à vos workflows en estimant votre rentabilité sur la base de ce tarif temporaire).
Pourquoi un modèle « plus intelligent » coûte en réalité plus cher à tarif identique ?
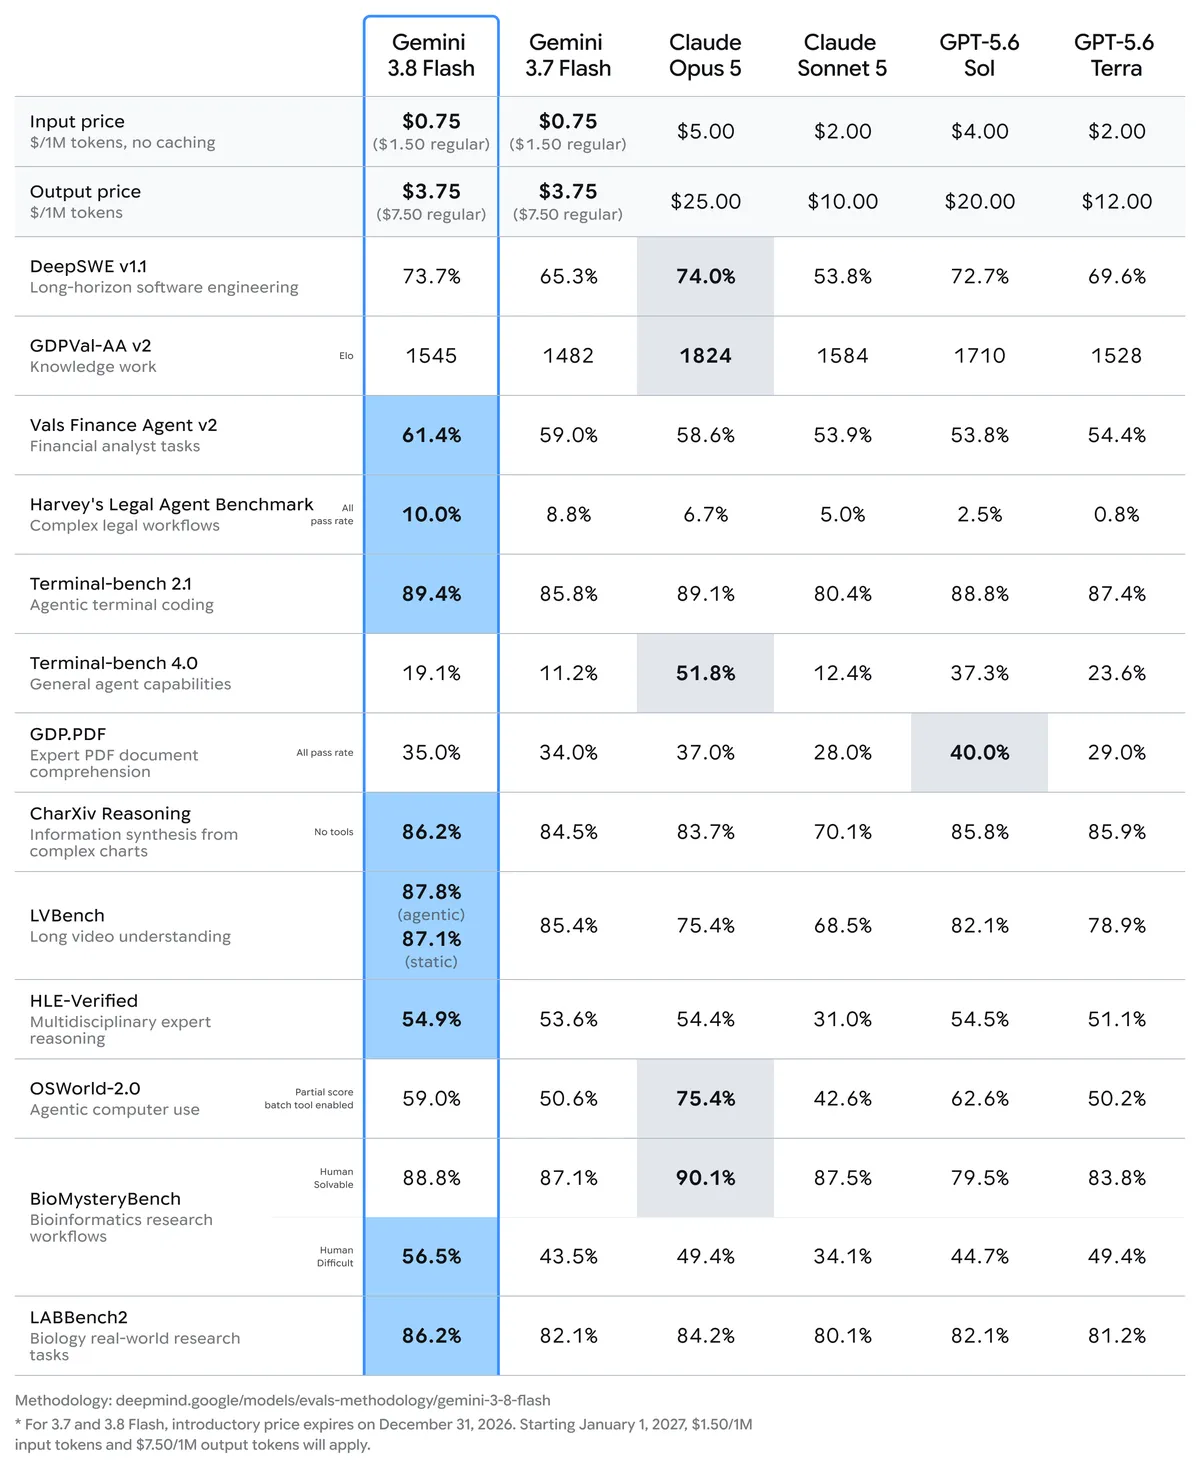
Le tarif au token, c’est le prix au litre. Ce qui a changé sur 3.8 Flash, c’est la consommation.
Google l’écrit en toutes lettres dans son annonce : le modèle « travaille plus » sur les tâches complexes, avec des étapes de raisonnement supplémentaires et des appels d’outils itératifs, quitte à mobiliser davantage de tokens aux niveaux d’effort élevés. Ce n’est pas un effet de bord, c’est le choix de conception qui produit aussi les gains de performance.
Les mesures indépendantes d’Artificial Analysis donnent un aperçu de ce que cela donne sur des cas concrets : pour passer l’Intelligence Index, 3.8 Flash (high) a généré 120 millions de tokens de sortie, contre une médiane de 71 millions pour les modèles comparables. La plateforme le classe donc explicitement dans la catégorie des modèles très verbeux (et qui dit verbeux, dit plus de tokens en sortie, et donc, une rentabilité dégradée sur chaque tâche sur laquelle il sera lancé).
Sept points d’indice séparent le réglage le plus économe du plus dépensier, et ces sept points se paient 2,4 fois plus cher.
En clair : le niveau d’effort n’est plus un paramètre technique laissé au développeur, c’est un paramètre qui doit aussi faire l’objet de ses propres tests internes afin de déterminer le meilleur rapport entre effort / coût / performance afin de maitriser au mieux votre budget.
PS : notre comparaison de rentabilité entre modèles que l’on met régulièrement à jour pourra vous aider à choisir le meilleur modèle, si jamais vous souhaitez tester des alternatives à Gemini 3.8 Flash.
Comment arbitrer entre 3.7 Flash, 3.8 Flash et les niveaux d’effort ?
Si vous devez trancher entre utiliser le nouveau et l’ancien modèle, Google vous donne une partie de la réponse, ce qui reste assez rare dans un article qui anonce un lancement : pour les tâches où l’efficience de calcul prime, l’éditeur recommande de baisser le niveau d’effort ou de rester sur 3.7 Flash, qui restera toujours pleinement supporté. Une recommandation qui implique que 3.8 ne sera pas la meilleure option pour tous vos usages qui étaient préalablement configurés sur 3.7 Flash.
En résumé :
- Toute interaction en front, où l’utilisateur attend devant son écran, devrait rester sur 3.7 Flash ou sur 3.8 Flash en effort bas.
- Les traitements longs et asynchrones, agents de code, analyse documentaire, batch nocturne, justifient l’effort élevé sur 3.8.
- Les tâches avec un prompt système stable gagnent à exploiter le cache, dont la remise atteint 90 % selon Artificial Analysis. C’est un levier clé à exploiter (et c’est valable pour tous les modèles).
En résumé, avec 41 points, Gemini 3.8 Flash se situe au 28e rang sur 200 modèles en intelligence brute. Il n’est pas le plus performant du marché, mais il reste très bien placé sur le rapport entre performance et coût, ce qui n’est pas la même promesse.
Notre verdict :
Gemini 3.8 Flash offre l’un des meilleurs rapports intelligence/prix du marché et c’est aussi réellement le plus rapide sur plus de 200 modèles analysés. Ce modèle sera donc un excellent choix pour les traitements de fond, mais un mauvais choix pour tout ce qui répond à un humain en temps réel (si vous optez pour le niveau d’effort élevé). Et faites attention à bien chiffrer votre rentabilité sur les tarifs 2027 et non sur ceux qui concernent le lancement.
PS : notre classement des meilleurs modèles d’IA donne le détail des positions (on le met à jour régulièrement).
Sources : Google et Artificial Analysis.